本文导航
MySQL手记
基础知识
连接
mysql连接命令要在MySQL的安装目录下的bin目录下执行,Mac系统的默认安装位置为/usr/local/mysql/bin
-
单实例连接
所谓单实例连接就是在一台机器上只有一个MySQL实例
mysql -h host -u user -p -
多实例连接
所谓多实例连接就是在一台机器上有多个MySQL实例
mysql -h host -u user -p -S /tmp/mysql.sock*mysql.sock*代表可能是mysql.sock1、mysql.sock2等。不知道是多少怎么办?
其配置信息在MySQL的配置文件my.conf中[mysqld]部分的socket部分配置
数据类型
Numeric-数值类型
整数:
有符号-Signed
无符号-Unsigned
1字节 = 8位
计算规则:($n = 2 \times 8 \times 所占字节数$)
- 如果是有符号,最小值则为$-2^{n-1}$,最大值则为$2^{n-1} -1$
- 如果是无符号,最小值为0,最大值则为$2^n -1$
为什么有符号的是$2^{n-1}$,既然有符号,就要分正负,则要把这个数分成两部分,肯定要在正常的基础上除以2,指数运算,两个数相除,则指数相减
| 类型 | 占字节数 | 有符号最小值 | 有符号最大值 | 无符号最小值 | 无符号最大值 |
|---|---|---|---|---|---|
| TINYINT | 1 | $-(2^{8-1}) = -(2^7)= -128$ | $2^{8-1} -1 = 2^7 - 1 = 127$ | 0 | $2^8 -1 = 255$ |
| SMALLINT | 2 | $-(2^{16-1}) =-(2^{15})= -32768$ | $2^{16-1} - 1 = 2^{15} - 1 = 32767$ | 0 | $2^{16} -1 = 65535$ |
| MEDIUMINT | 3 | $-(2^{24-1}) = -(2^{23})=-8388608$ | $2^{24-1} -1 = 2^{23} -1 = 8388607$ | 0 | $2^{24} -1 = 1677215$ |
| INT | 4 | $-(2^{32-1}) = -(2^{31}) = -2147483648$ | $2^{32-1} -1 = 2^{31} -1 = 2147483647$ | 0 | $2^{32} -1 = 4294967295$ |
| BIGINT | 8 | $-(2^{64-1}) = -2^{63}$ | $2^{64-1} -1 = 2^{63} -1$ | 0 | $2^{64} -1$ |
int(5)这种写法代表什么?
表示当数值宽度小于5位的时候在数字前填满宽度,一般搭配zerofill使用。不代表实际所占用的存储空间字节数,上面的表格已经确定了每个类型所占的字节数。
浮点数
带有小数点的数字:3.14、7.9869等
FLOAT(M, D) 4个字节 单精度
DOUBLE(M, D) 8个字节 双精度
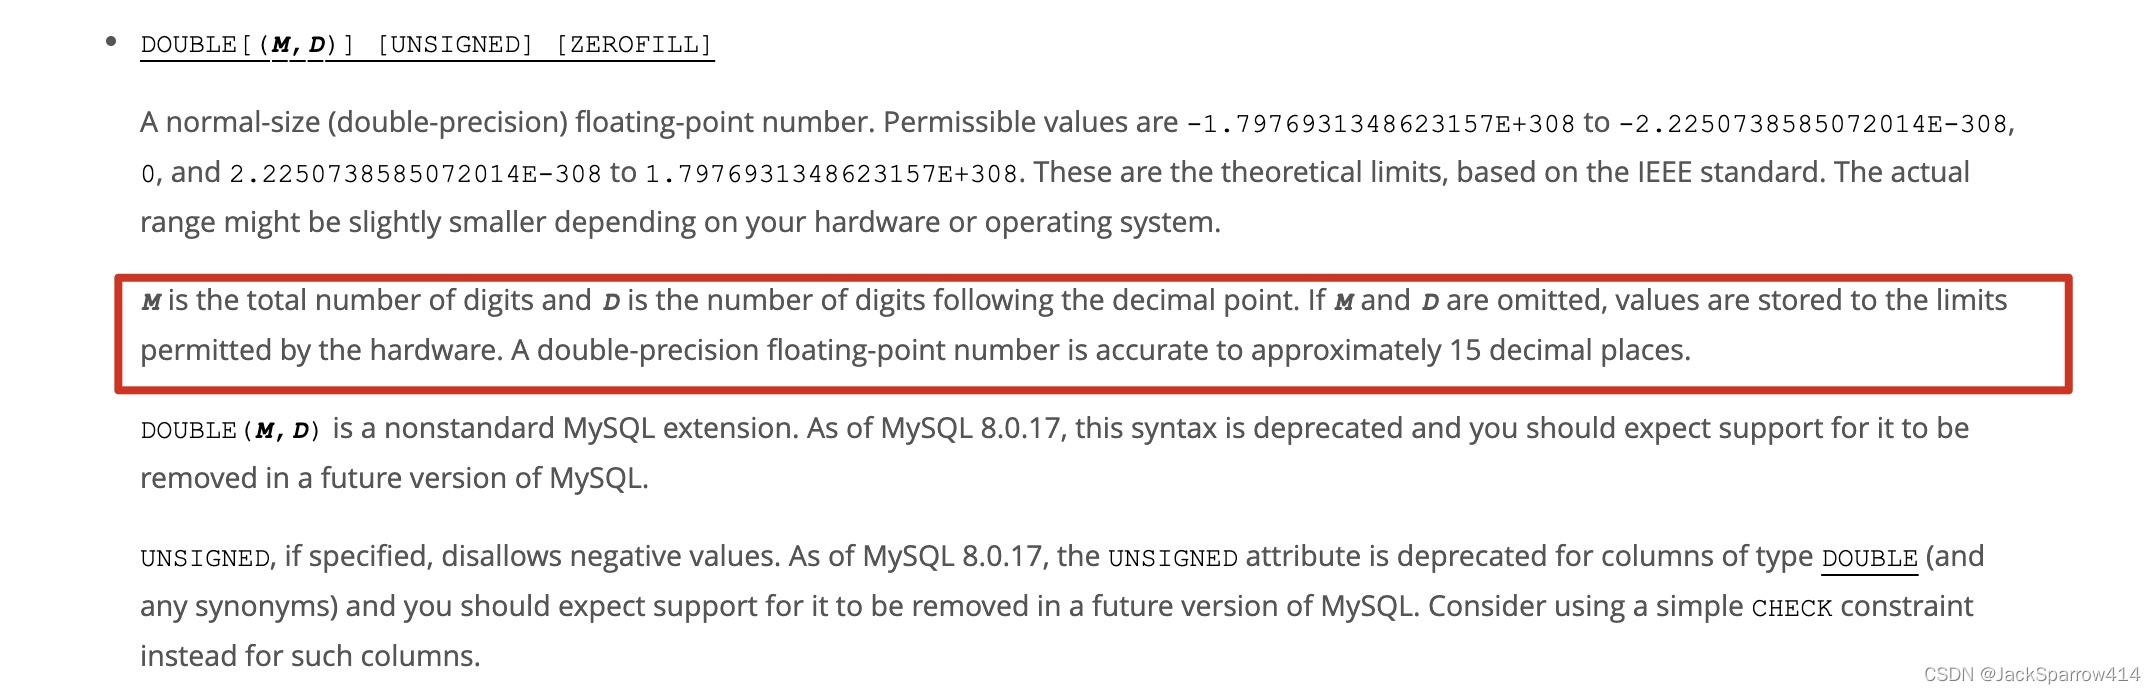
M = 整数位 + 小数位
D = 小数点后面的位数
D表示的位数应该不大于 M-2,最大可能为30
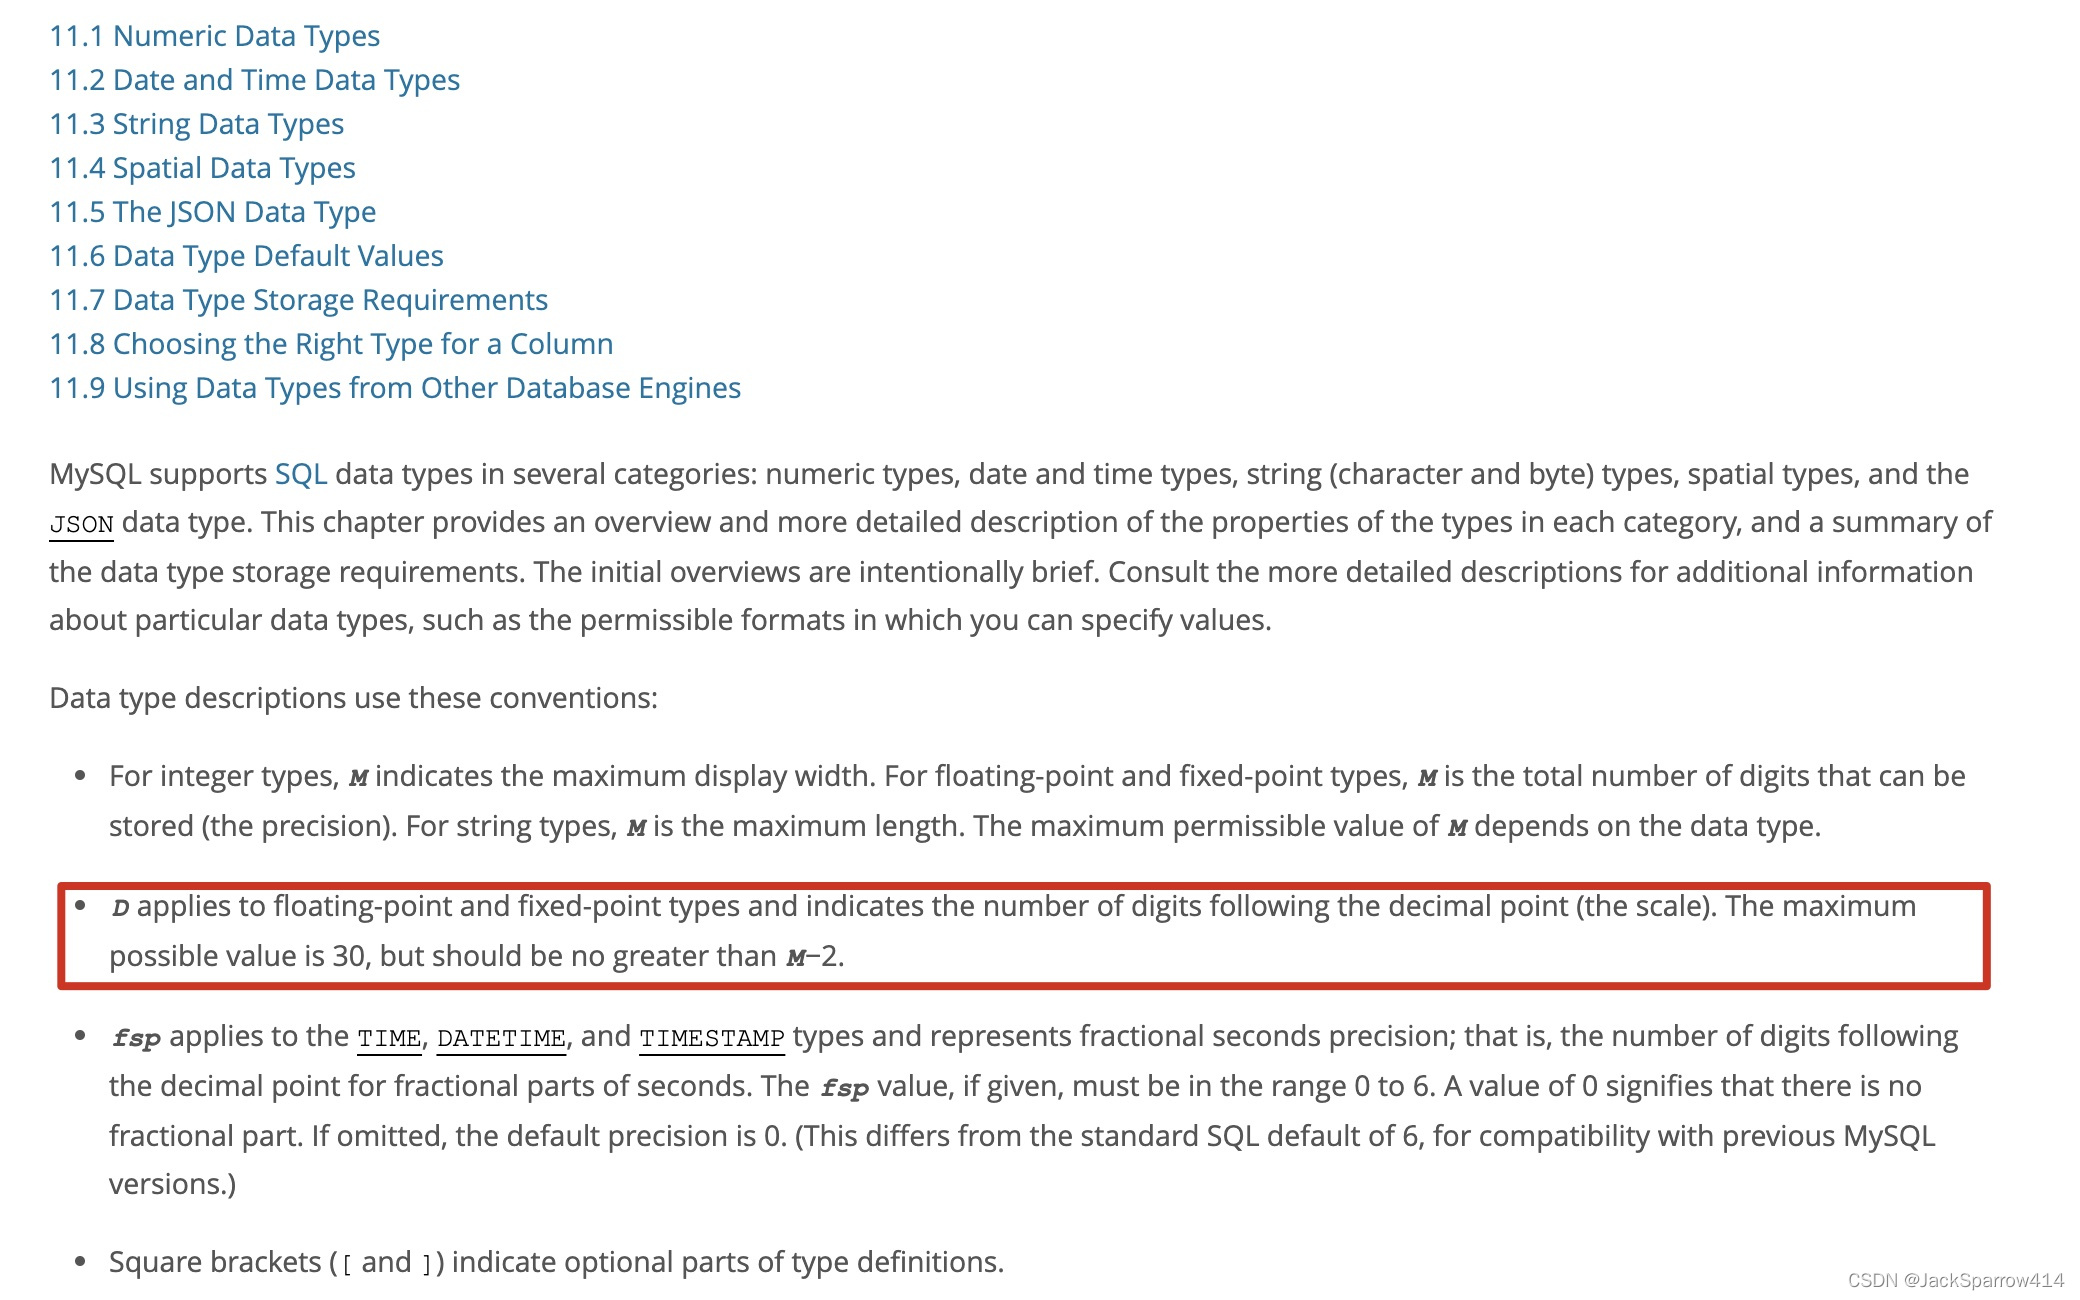
如: float(5, 2) 表示一共有5位数字,其中小数部分占2位,如果小数部分超过2位,则四舍五入保留2位
如果未指定精度,由实际硬件决定
定点数:
DECIMAL(M, D) M+2个字节,一般用来表示货币等精度高的数据
未指定精度时,默认为(10, 0)
Date、Time -日期类型
| 类型 | 占字节数 | 最小值 | 最大值 | 插入错误数据时默认值 |
|---|---|---|---|---|
| DATE | 4 | 1000-01-01 | 9999-12-31 | 0000-00-00 |
| DATETIME | 8 | 10-01-01 00:00:00 | 9999-12-31 23:59:59 | 0000-00-00 00:00:00 |
| TIMESTAMP | 4 | 1970-01-01 00:00:01 | 2038-01-19 03:14:07 | 0000-00-00 00:00:00 |
| TIME | 3 | -838:59:59 | 838:59:59 | 00:00:00 |
| YEAR | 1 | 1901 | 2155 | 0000 |
DATE:
DATETIME:
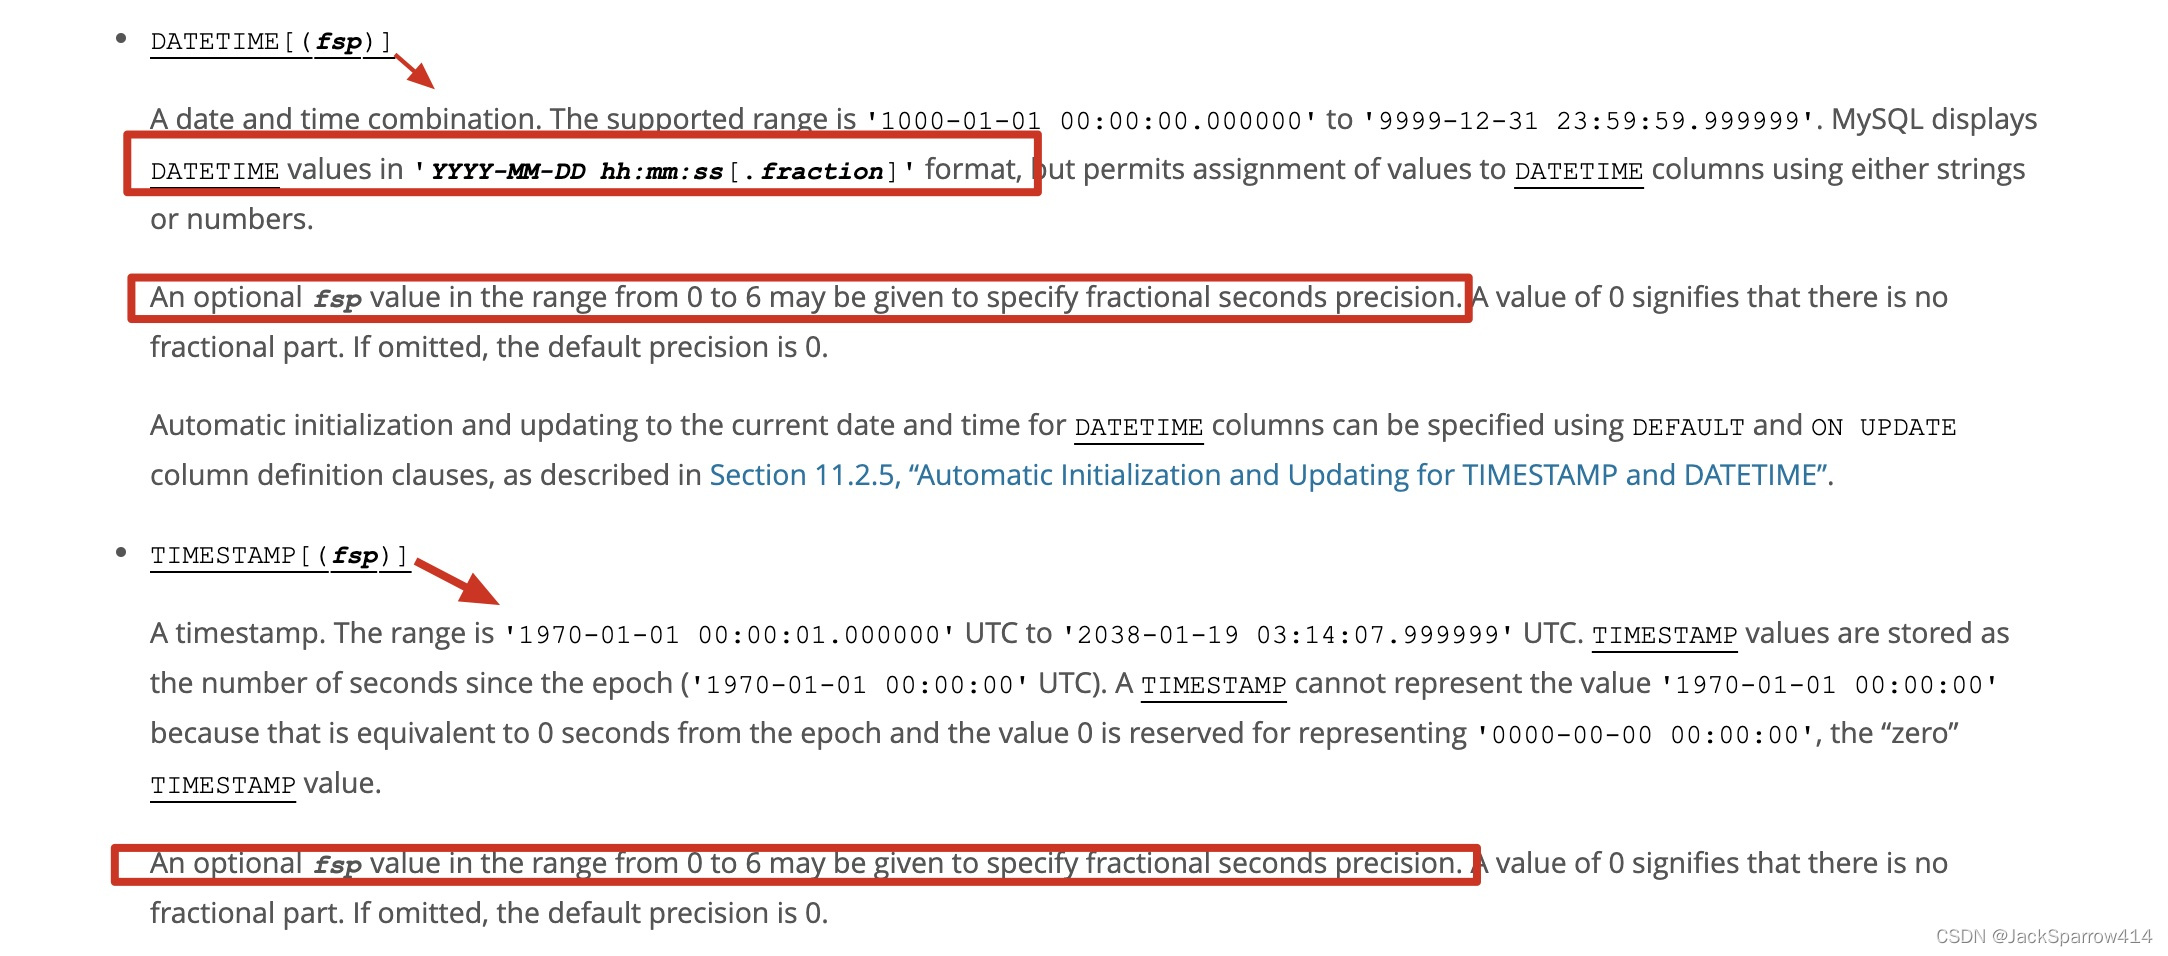
DATETIME[(fsp)] - DATETIME(3)
fsp范围为0-6
DATETIME和TIMESTAMP表示年-月-日 时:分:秒之后,还可以再加6位微秒。最多6位。显示为1000-01-01 00:00:00.000000
TIMESTAMP:
相同的年月日时分秒格式,相较于DATETIME,TIMESTAMP占用字节较少,只占4个字节。不过TIMESTAMP只能表示的最大范围只到2038年的某个时刻。
TIMESTAMP会受时区影响,插入、查询都会先转换为本地时区。所以对于同一条数据,不同时区的用户,看到的时间可能是不一样的
如何在插入、更新时自动更新数据的字段为当期时间?
DEFAULT CURRNT_TIMEAMP ON UPDATE CURRENT_TIMESTAMP注意:该设置对于字段类型为DATETIME和TIMESTAMP均有效
示例:
ALTER TABLE t1 ADD COLUMN birthday DATETIME DEFAULT CURRENT_TIMESTAMPALTER TABLE t1 MODIFY COLUMN birthday DATE DEFAULT CURRENT_TIMESTAMP ON UPDATE CURRENT_TIMESTAMPString-字符串类型
CHAR(M):
char类型是定长字符串,M最大值为0-255,如果未达到M个字节,则用空格填充。一个汉字、一个英文字母均占一个字节
VARCHAR(M):
VARCHAR是可变字符串,M最大值为65535,如果VARCHAR类型的字段存储值未超过255个字节,则VARCHAR前缀占用1个字节,如果超过了255个字节,则VARCAHR前缀占用2个字节。所以VARCHAR类型的字段的值所占用的
总的字节数 = 1或者2 + 实际值的字节数
BLOB:
TINYBLOB、MEDIUBLOB、LONGBLOB
用于存储二进制的数据
TEXT:
TINYTEXT、MEDIUMTEXT、LONGTEXT
用于存储非二进制数据
二者存储范围相同,只不过作用对象不同
其他类型
JSON、ENUM、SET
DDL、DML、DCL
MySQL关键字和保留字
直接在官方关键字文档里查询即可
主键和非主键的区别?
MySQL中聚簇索引和非聚簇索引的区别?
答:
- 聚簇索引-是索引结构和数据一起存放的索引,主键索引属于聚集索引,可以直接根据索引找到对应的数据。聚集索引的缺点:依赖有序数据,如果索引的数据不是有序的,那么需要在插入时排序,如果是整型还好,但是像字符串、UUID这种长度比较长,又难比较的数据,插入肯定会慢。更新代价比较大
- 而非聚簇索引,会根据索引找到对应数据的主键,再根据主键进行查询,非聚集索引的更新代价就没有聚集索引那么大了,非聚集索引的叶子节点是不存放数据的
主键和唯一索引的区别?
答:
- 主键不允许有空值,而唯一索引列允许空值
- 一个表中只能有一个主键,可以有多个唯一索引
- 主键是数据库的一种约束
innoDB和myIsam的区别
答:
- 锁范围不同,myIsam仅支持表级锁,innodb支持行级锁、表级锁
- innodb支持事务,myisam不支持事务
- innodb支持外键,myisam不支持外键
- Innodb支持MVCC
对于线上一个有几十万的表加一个字段,如何处理?
答:加字段会引起锁表,可以使用 pt-online-schema-change这种专业的工具修改表结构
innodb下能不设置主键吗?主键可以为空吗?可以设置几个主键?
答:
- 可以不设置主键,如果不设置主键,MySQL会有一个rowId作为隐藏主键,官方文档,主键的作用是保证数据的唯一性和完整性
- 如果设置了主键,主键不能为null,如果为null,会报Field ‘主键列名’ doesn`t hava default value
- 只可以有一个主键,所谓的多个主键-联合主键,是用多个字段一起作为一张表的主键
进阶知识
事务
支持事务的MySQL引擎是InnoDB.
事务是一个独立的原子工作单元,当事务对数据库进行多个更改时,要么在提交事务后所有更改成功,要么在事务回滚时撤销所有更改
ACID
A: atomicity 原子性 要么全部成功、要么全部失败
C: cunsistency 一致性
I: isolation 隔离性,事务之间互不影响
D: durability 持久性 一旦事务提交,所做的修改就会保存到数据库中
isolation-隔离级别
事务隔离级别分别各自的使用场景是什么?
查询当前事务界别
select @@session.transaction_isolation;查询全局事务界别
select @@global.transaction_isolation;如何在配置文件my.conf中指定事务隔离级别?在上面的文档中有
Dirty Read-脏读:
定义:在事务B中读取到了事务A中还未提交的改动的数据
演示如下
两个客户端连接至同一个MySQL数据库,
在客户端A开启事务,更新数据,暂不提交
# 设置事务隔离级别为读未提交read uncommitted
set session transaction isolation level read uncommitted;
# 开启事务
start transaction;
# 更新数据
update gener set gener = 56 where id = 12;
在客户端B开启事务,查询数据,发现可以查到客户端A的未提交的事务的数据
set session transaction isolation level read uncomitted;
start transaction;
select * from gener where id = 12;
结果如下图:
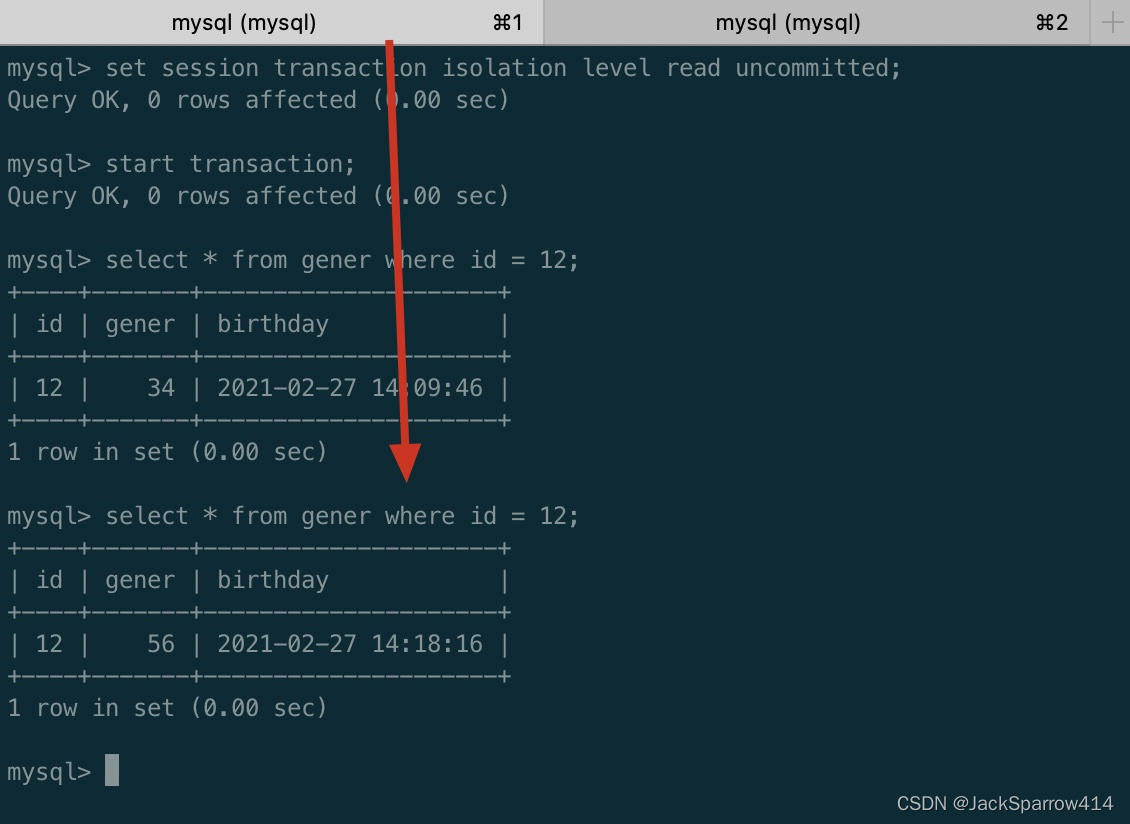
可以看到,对于事务隔离级别为read uncommitted情况下,是非常容易出现脏读的
Nonrepeatable Read-不可重复读
定义:事务B中多次读取同一条数据,发现不是每一次查询读出的数据都是一样的。
重复读的含义为:在整个事务内,无论什么时候读取数据,应该每次拿到的数据都是一样的
演示如下:
客户端A:
# 设置事务隔离级别为读已提交
set session transaction isolation level read committed;
start transaction;
update gener set gener = 66 where id = 12;
# 此时还未提交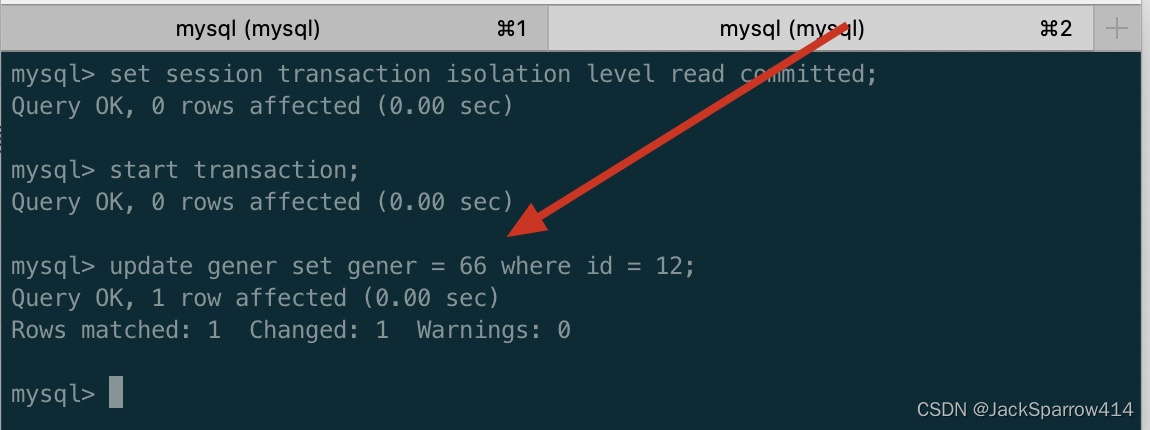
在客户端B查看同一条数据:
set session transaction isolation level read committed;
start transaction;
select * from gener where id =12;
结果如下:
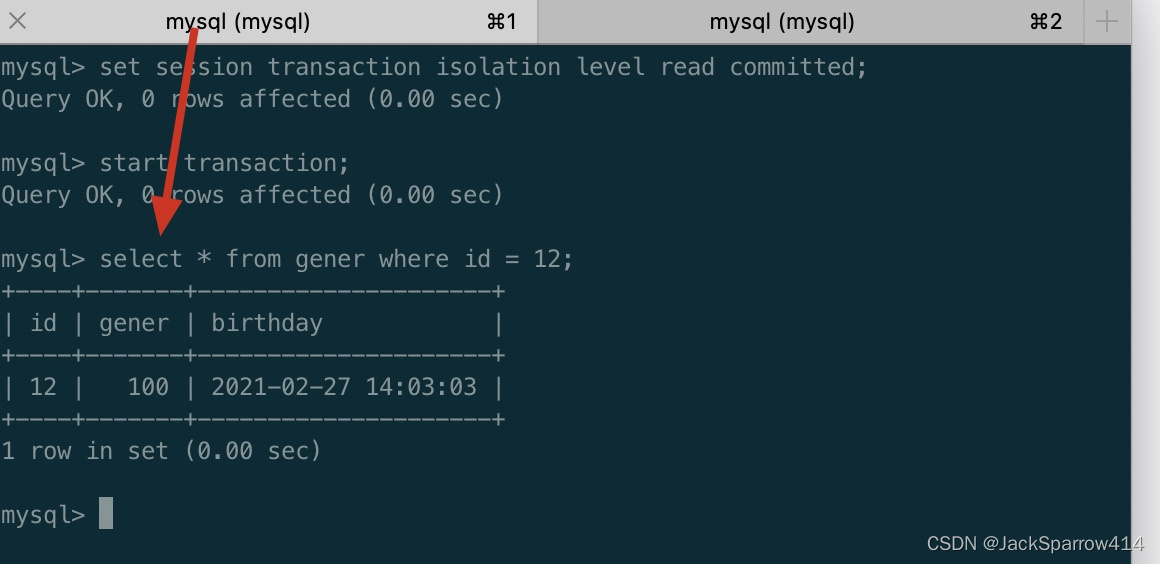 可以看到,对于事务隔离级别为读已提交read committed,可以防止脏读的出现
接下来,在客户端A提交事务,在客户端B事务中再次查询id=12的数据
客户端A:
commit;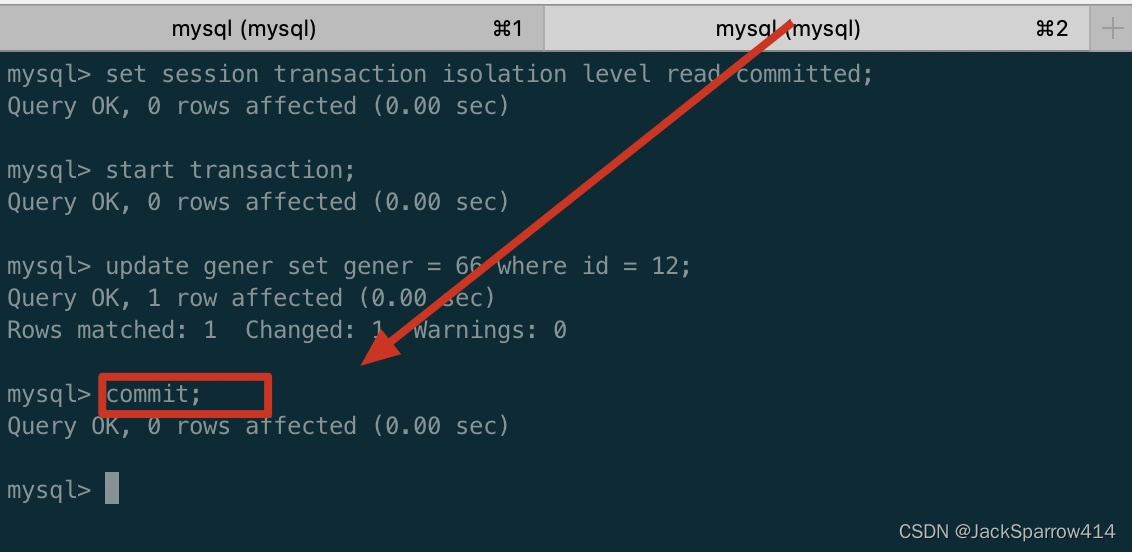
客户端B再次查询:
select * from gener where id =12;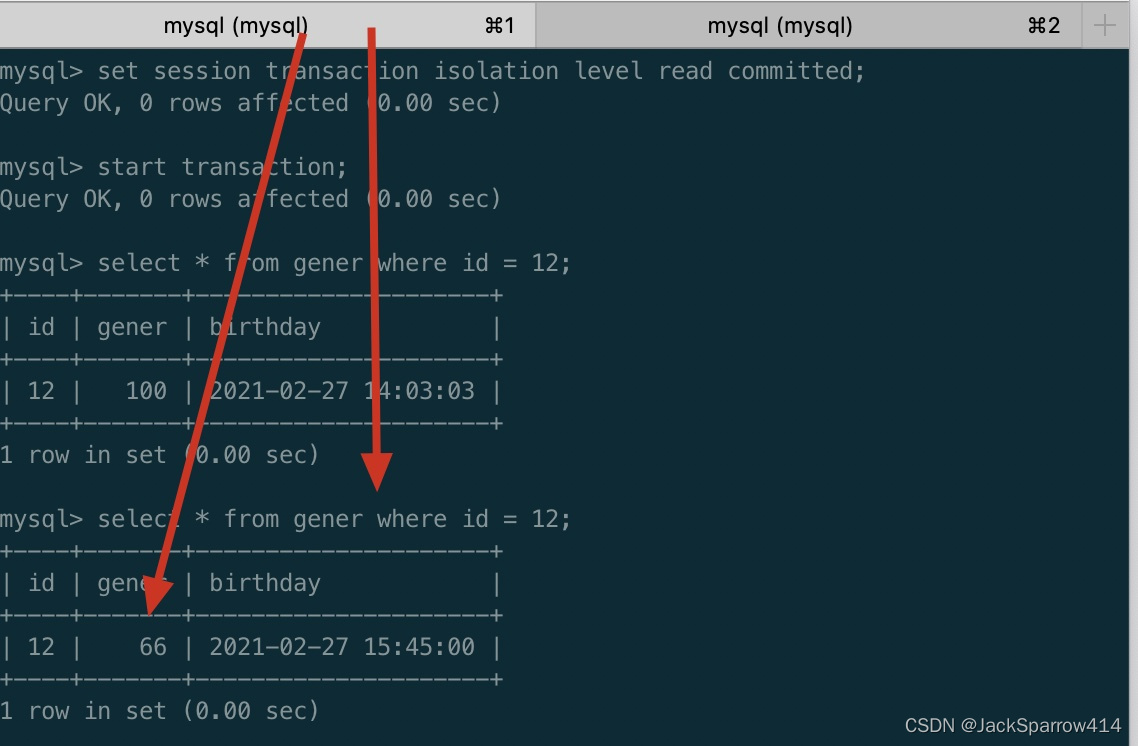
可以看到,在事务B中再次查询同一条数据,发现前后两次查询不一样。对于事务隔离级别为read committed,不能防止不可重复读
Phantom Read-幻读:
定义:事务B中进行insert、按条件update操作时,被告知该数据已经存在或者更新的行数不等于前一次的查询的行数。结合下面例子看,更容易懂
演示:
客户端A:
# 设置事务隔离级别为可重复读
set session transaction isolation level repeatable read;
start transaction;
insert into gener(id, gener) values (1998, 88);
commit;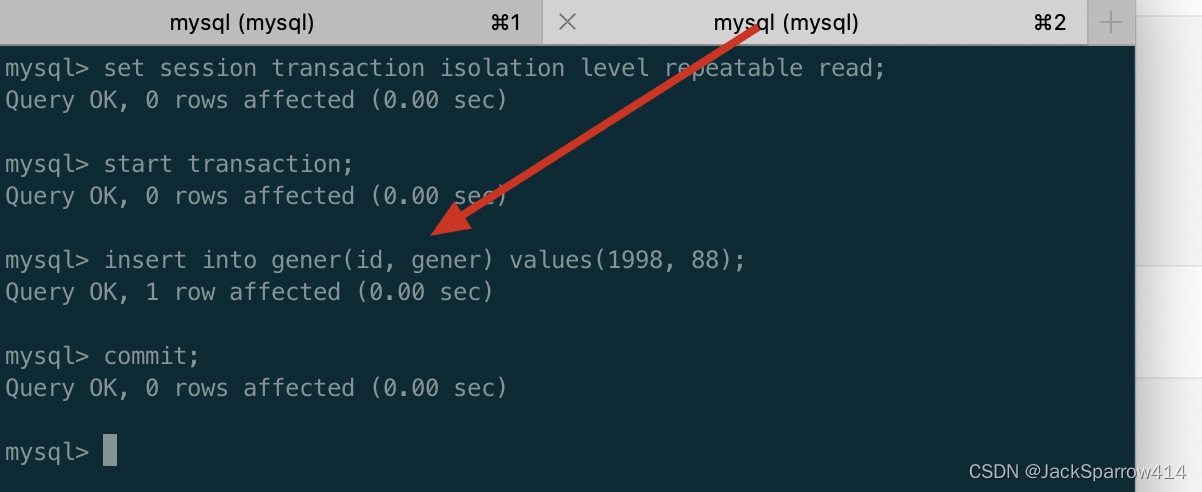
客户端B:
set session transaction isolation level repeatable read;
strat transaction;
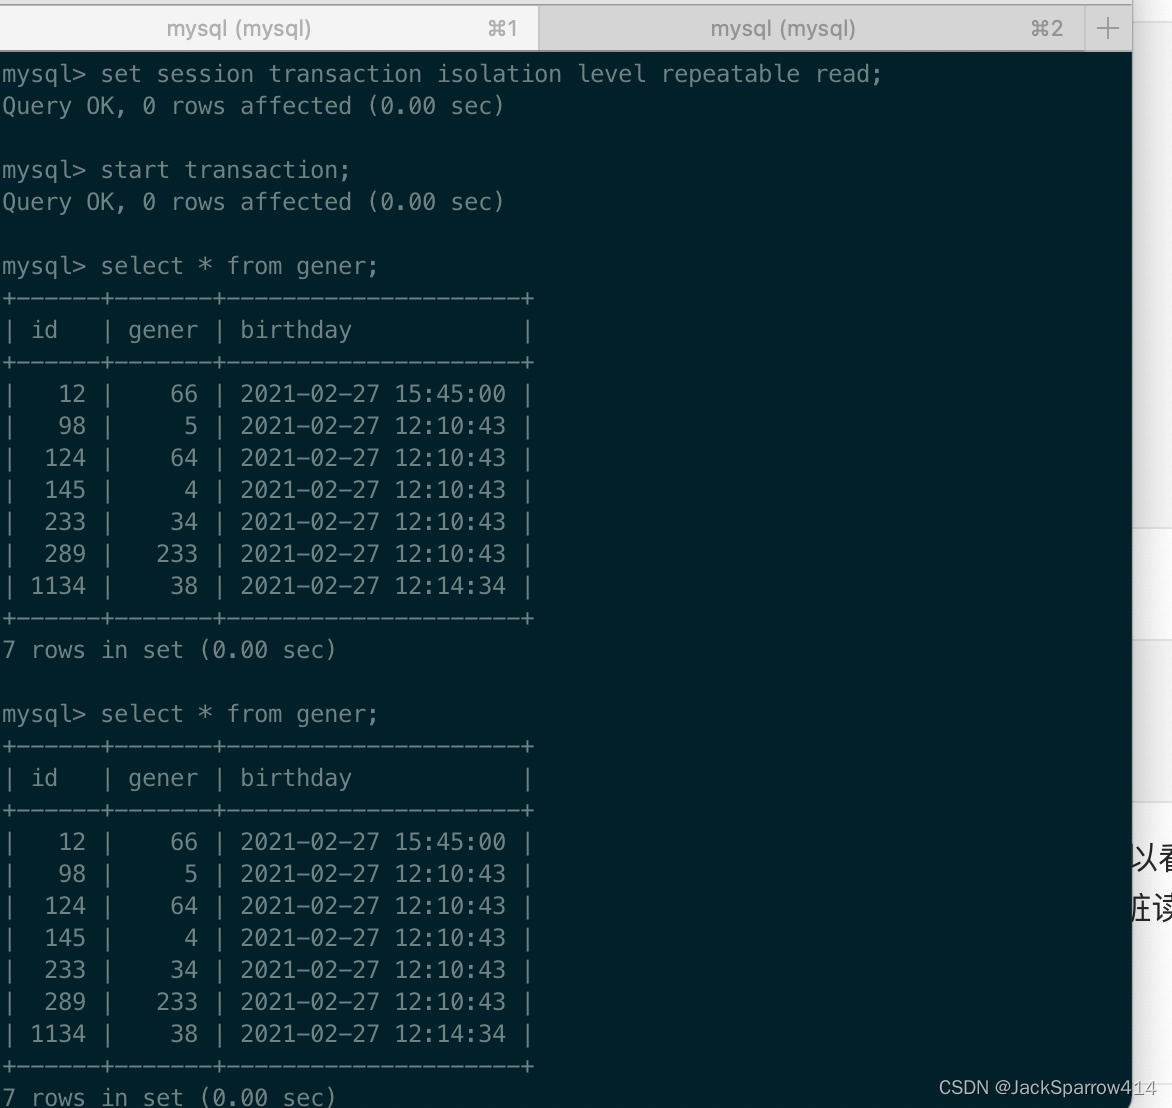
select * from gener;
分别在客户端A提交事务之前、之后进行两次查询,两次查询结果都是一样的。可以看到,事务隔离级别为repeatable read,在事务期间,每次查询结果都是一样的,可以防止脏读、不可重复读。
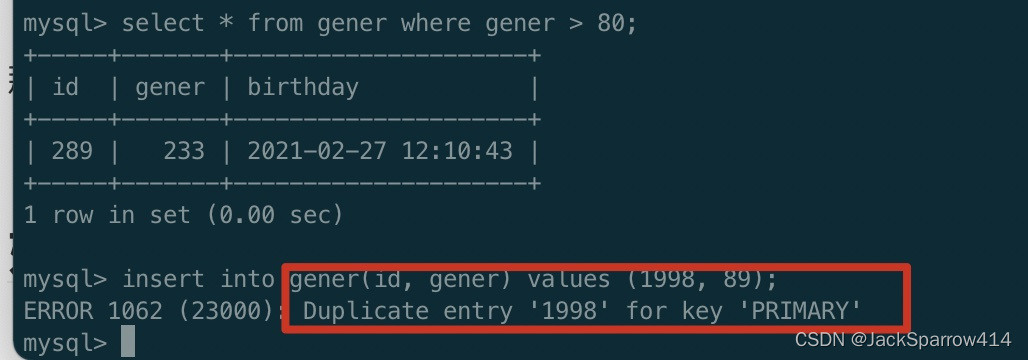
那么这时,在事务B中,我们插入同样ID的数据,则会报错
再拿这个场景举例update的情况,对于事务A刚才插入的数据,字段gener的值为88,
在事务B中进行如下查询
select * from gener where gener > 64;此时查询出来的结果为2条,接下来,在事务B中更新gener>64的数据gener+1,会发现,最后受影响的是三条数据
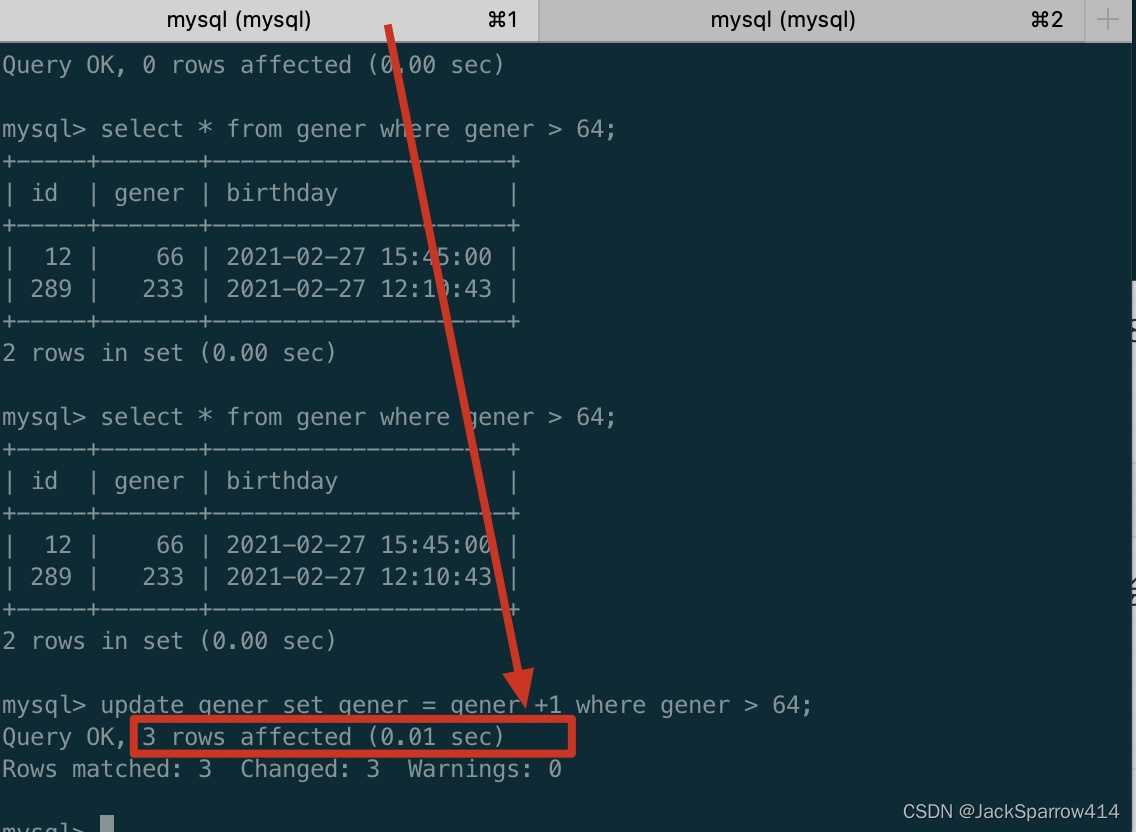
可以看到,这里就有问题了,按照事务B中刚才的查询,应该只有两条数据满足才对。这里却是三条,这是,先不提交事务B,再次查询,会发现,刚才事务A提交的数据被查出来了
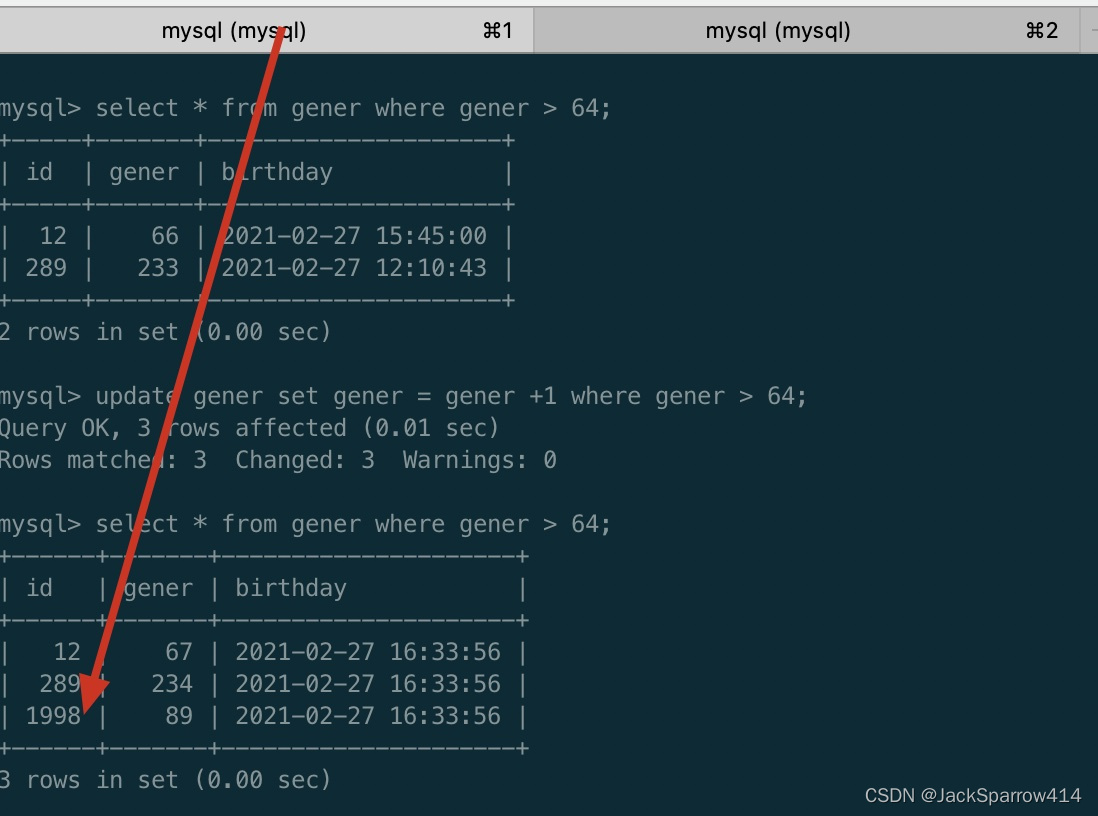 因此事务B产生了幻读,幻读和不可重复读有时候很容易被网上的一些概念给混淆。
可以看一下幻读的文章,这个解释的很详细了。
SERIALIZABLE串行化:
隔离的最高级别,脏读、不可重复读、幻读都不会发生。事务是串行方式进行的
通过以上演示,就可以知道常说的缩写代表什么了
RU - read uncomitted -读未提交
RC - read committed - 读已提交
RR - repeatable read - 可重复读
间隙锁-Next key锁
在上面的说明中,RR隔离级别下,还是可能产生幻读,可以通过间隙锁来保证不会出现幻读,设计目的是防止多个事务将记录插入到同一范围内。
例如:
select * from emp where empid > 100 for update假设此时表中只有101条数据,那么此SQL不仅会对id为101的数据加锁,同时也会对empid大于101的数据加锁,即使这些数据并不存在。
此时如果
insert into emp values (102);那么会阻塞
间隙锁的好处很明显,防止了幻读的发生。但是坏处也很明显,会阻止符合条件的数据并发插入,在并发高的情况下,会造成严重的锁等待
MySQL中存储引擎使用MyIsam,Spring的事务会生效吗?
答:
即使Spring是在代码层面做了限制,那么其实MyIsam存储引擎是不支持事务的,所以,一旦在数据入库的过程中失败,那么即使代码层面没有报错,数据的ACID是保证不了的
索引
CREATE [UNIQUE | FULLTEXT | SPATIAL] INDEX index_name
    [index_type]
    ON tbl_name (key_part,...)
    [index_option]
    [algorithm_option | lock_option] ...

key_part: {col_name [(length)] | (expr)} [ASC | DESC]

index_option: {
    KEY_BLOCK_SIZE [=] value
  | index_type
  | WITH PARSER parser_name
  | COMMENT 'string'
  | {VISIBLE | INVISIBLE}
  | ENGINE_ATTRIBUTE [=] 'string'
  | SECONDARY_ENGINE_ATTRIBUTE [=] 'string'
}

index_type:
    USING {BTREE | HASH}

algorithm_option:
    ALGORITHM [=] {DEFAULT | INPLACE | COPY}

lock_option:
    LOCK [=] {DEFAULT | NONE | SHARED | EXCLUSIVE}
创建索引如下:
CREATE INDEX idx_gener USING BTREE ON gener (gener);删除索引:
DROP INDEX index_name ON tbl_name;索引类型
NORMAL
FULLTEXT -全文索引
UNIQUE - 唯一索引
SPATIAL - 空间索引
索引方法
BTREE和HASH
B-Tree和Hash索引方法的区别文档地址,简单总结下之间的区别
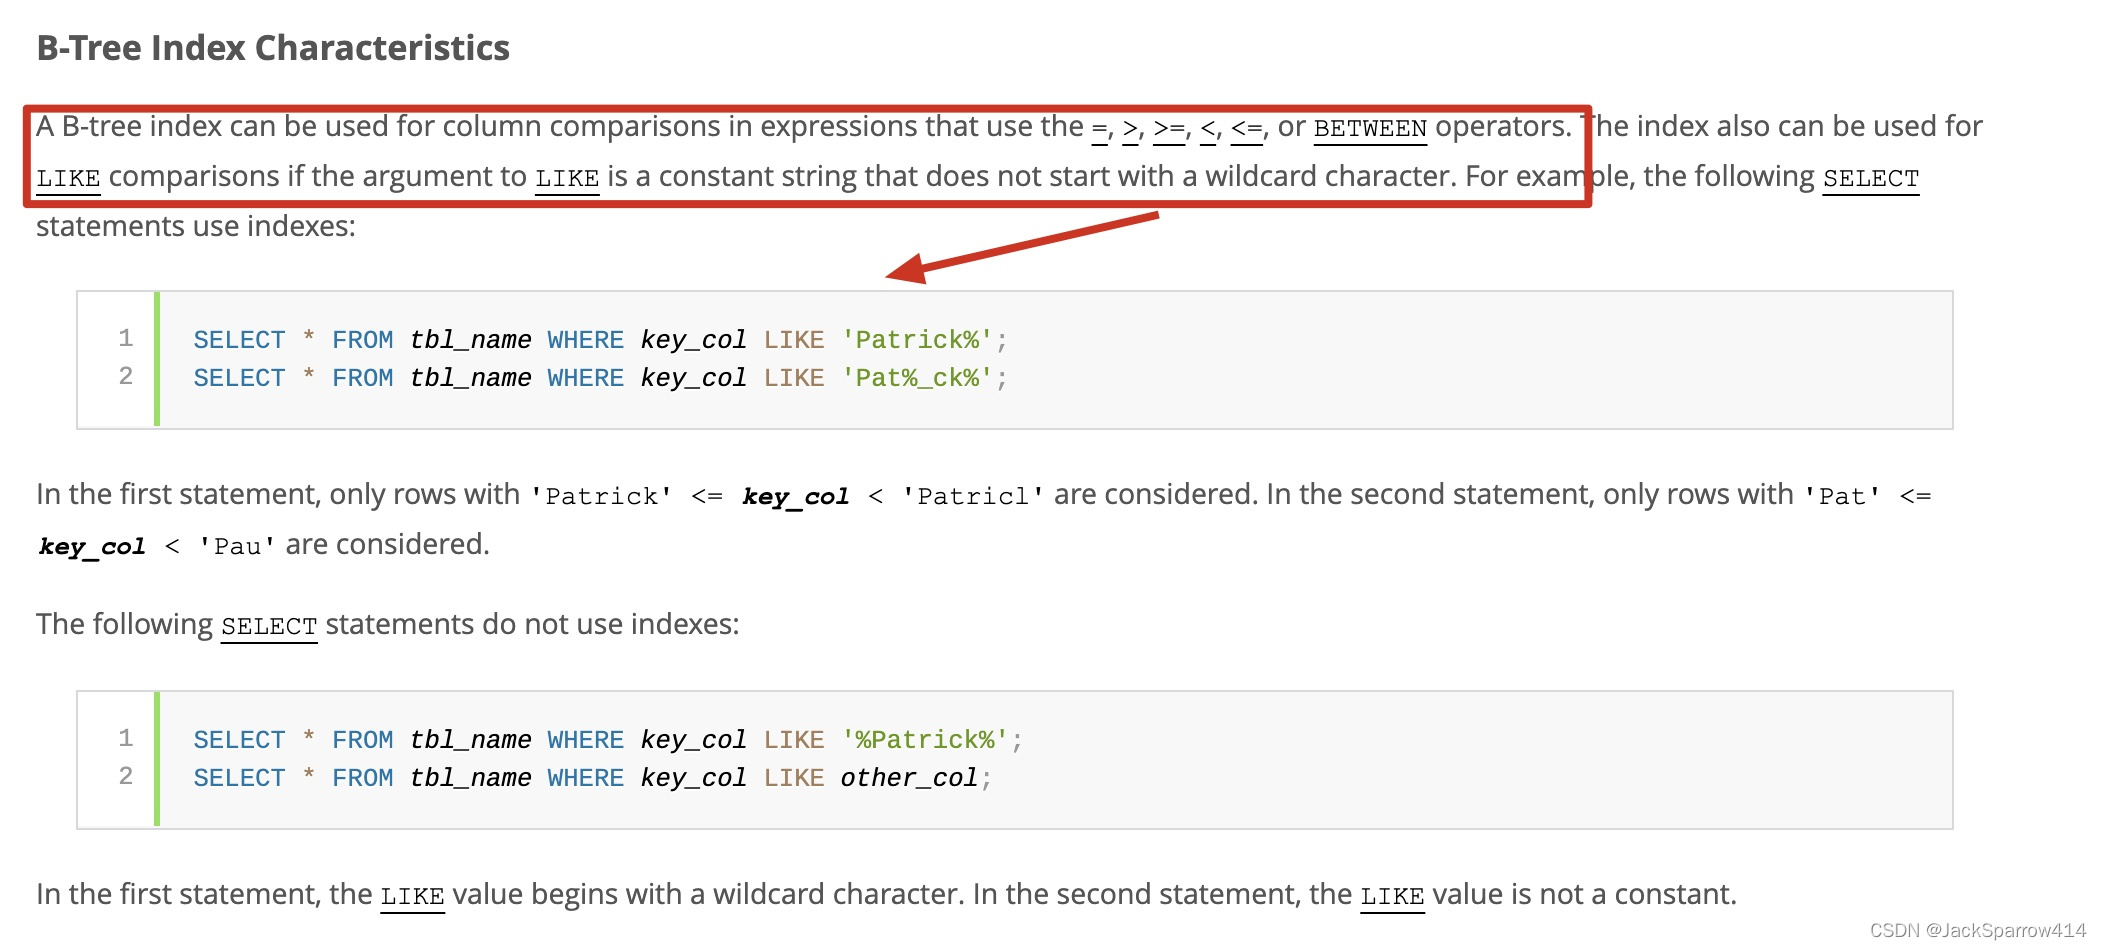
- B-Tree索引方法支持的操作符比Hash索引方法支持的操作符要多,B-Tree支持的操作符有=,>,>=,<,<=,BETWEEN,LIKE,其中LIKE只要不是以%开头,就可以用上索引
-
Hash索引只用=或者<=>,可以看到Hash索引支持的操作符太少了,并且优化器不能使用Hash索引来加速ORDER BY操作
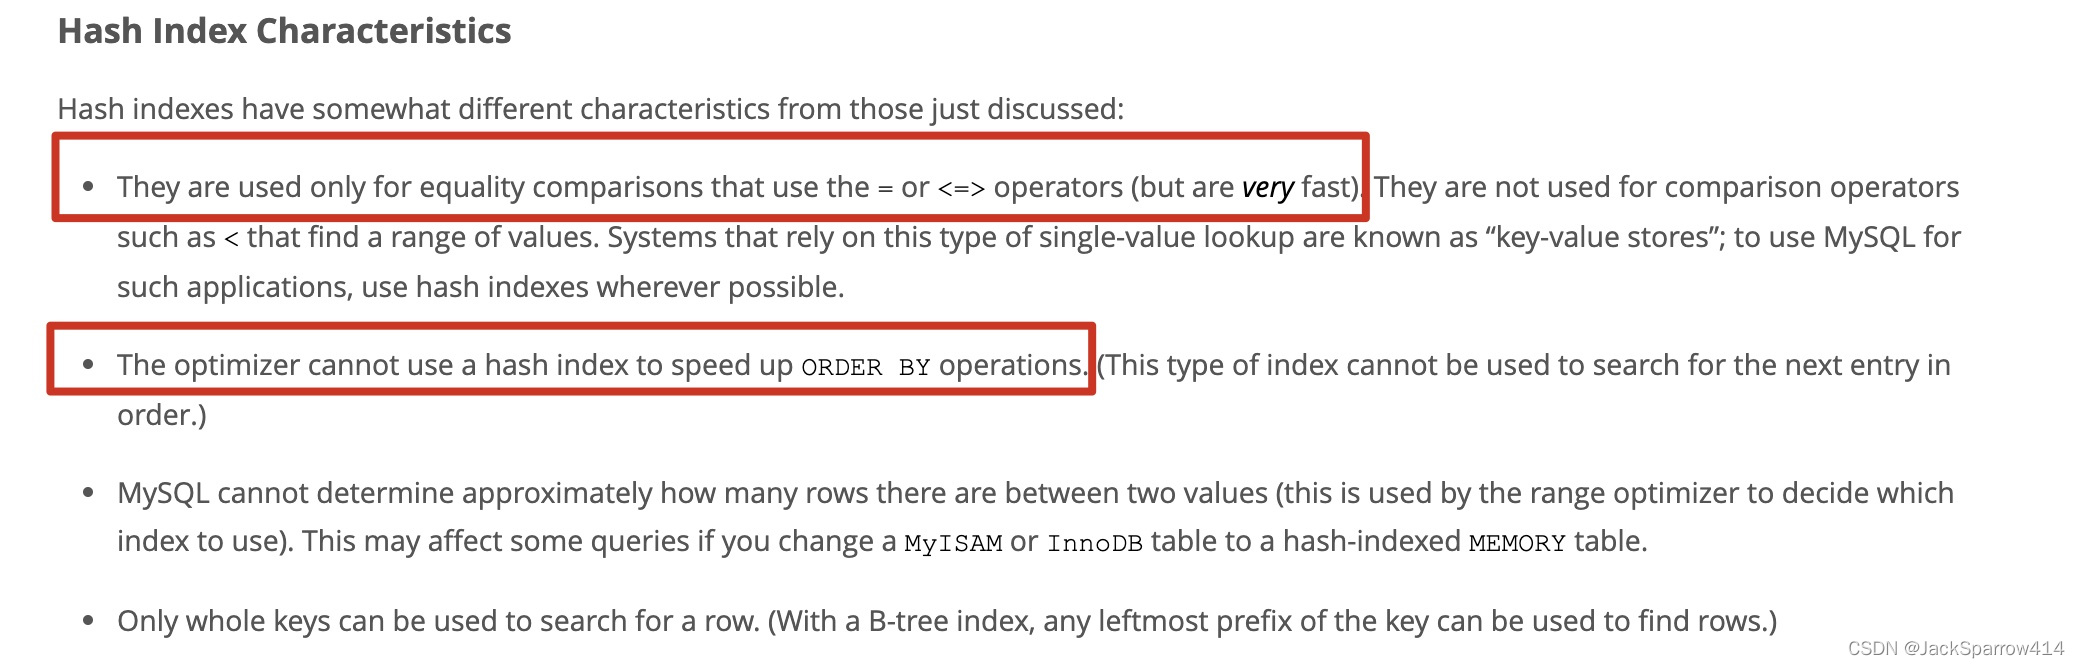
所以对于索引如果SQL语句针对索引字段,只涉及=或者<=>,则可以考虑使用hash索引,其他情况建议使用B-Tree索引
索引失效场景
-
数据类型隐式转换,比如字段类型是bigint,而查询时候使用了”字符串,反之也一样
-
在LIKE的时候使用%开头,会导致索引失效
-
查询条件中使用函数计算,如
select * from employees where char_length(first_name)=5 limit 10;
多个索引MySQL使用哪个索引?数据库字段b,c上都具有普通索引,那么MySQL会优先使用哪个索引?为什么?
答:
是否朝着MySQL优化器的方向去回答
SQL优化
通过EXPLAIN 查看SQL执行计划
使用如下:
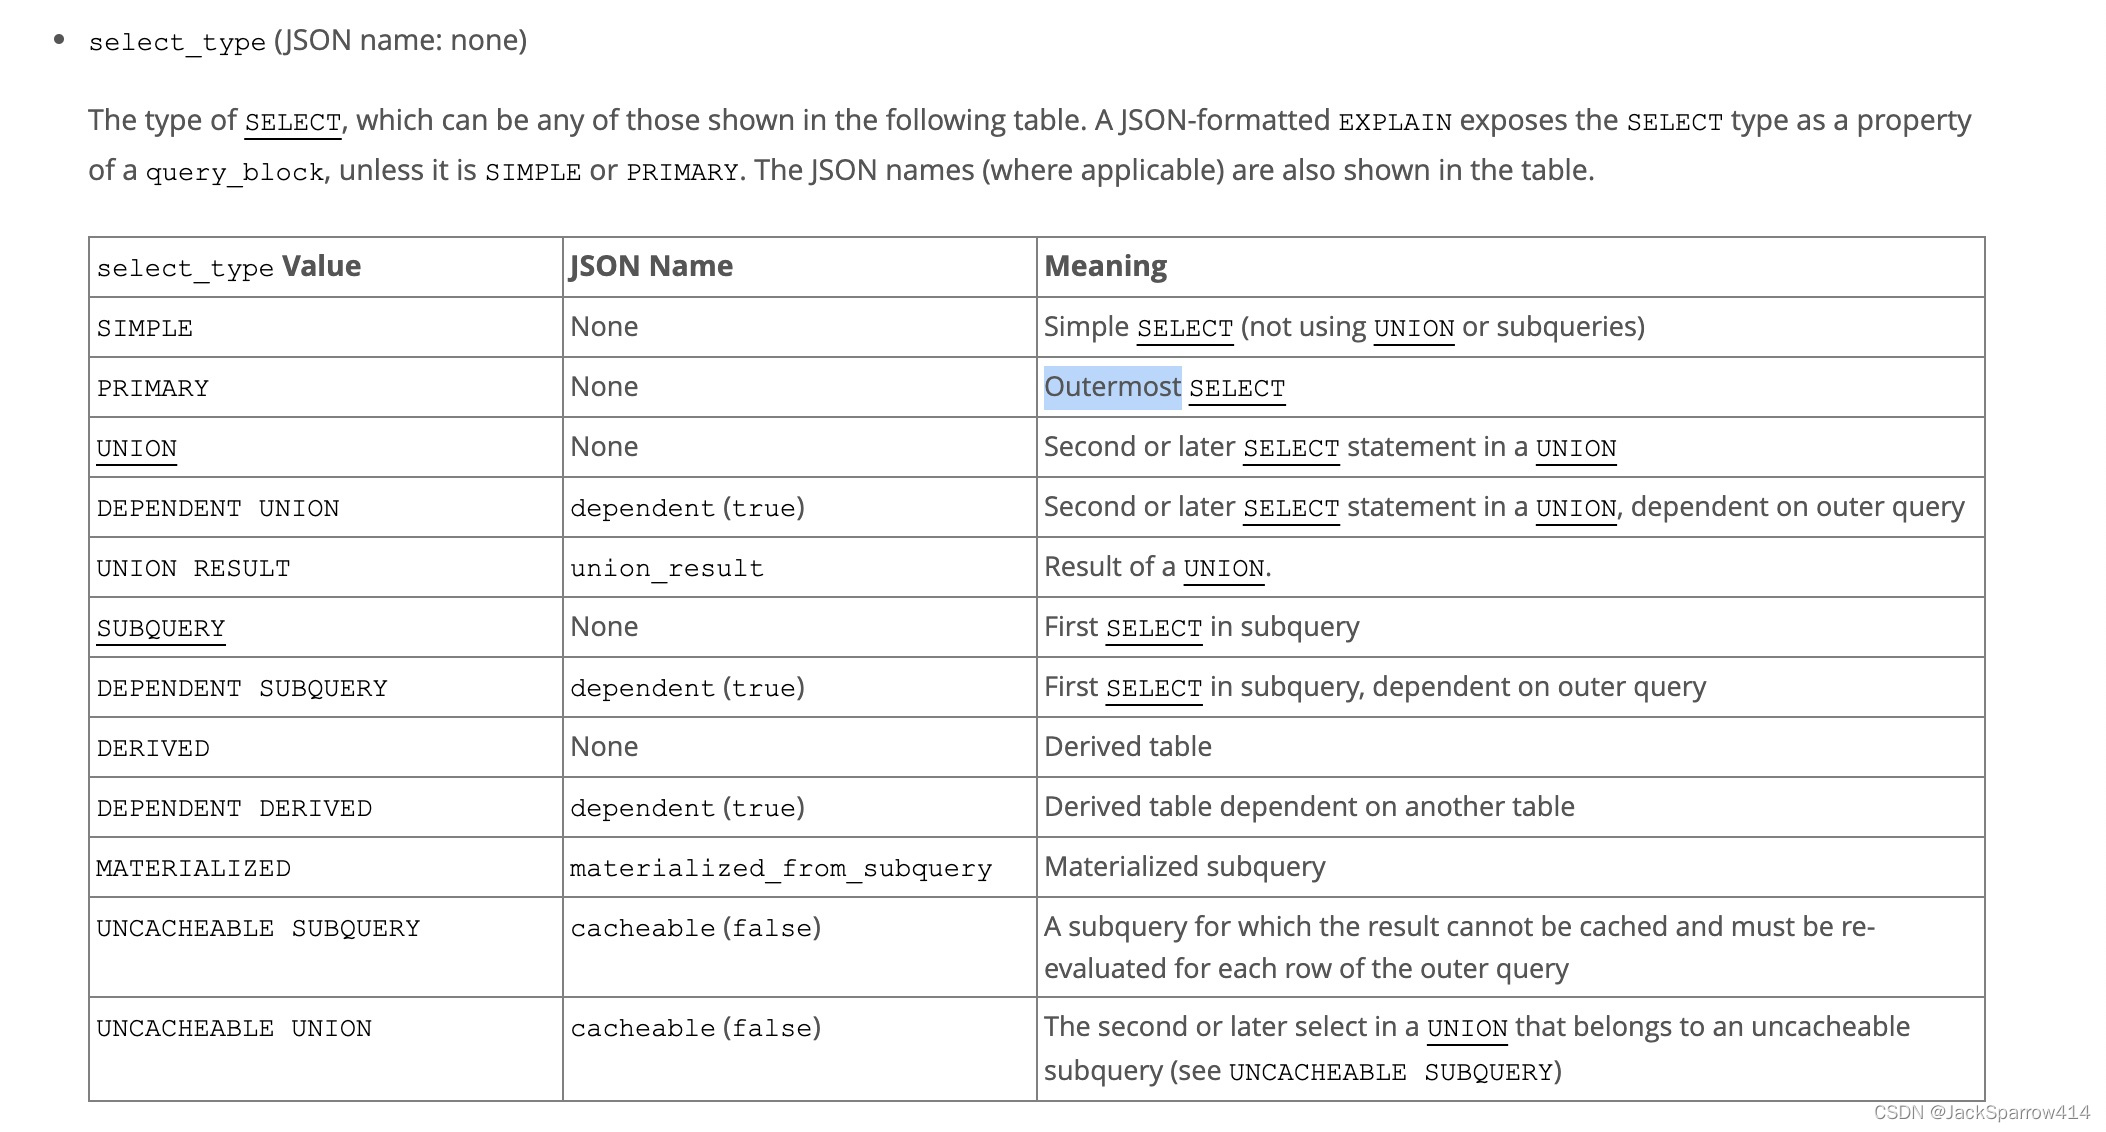
explain select * form gener where id > 64;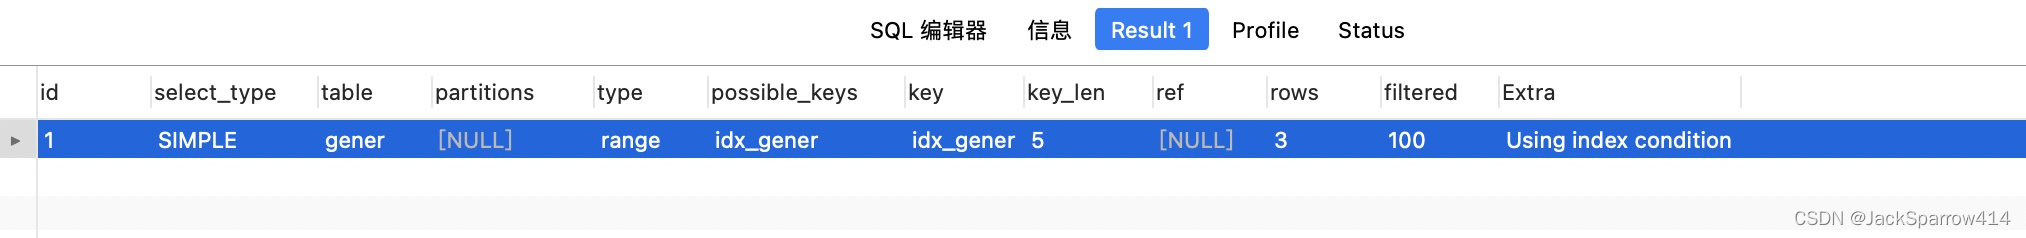 select_type一般有:SIMPLE-单表、PRIMARY-主查询、UNION、SUBQUERY-子查询
 重点关注type、possible_keys、key、rows、key_len.
其中type,性能从好到坏依次为
- system、const
- eq_ref 唯一索引
- ref 非唯一索引或者唯一索引的前缀扫描
- range 范围查询,常见于 <,<=, > , >=, BETWEEN
- index 索引树被全扫描
- ALL 全表扫描
possible_keys 代表可能用到的索引
key 代表实际用到的索引
rows 代表MySQL必须要查询的行数
MySQL 几种日志
slow query log
作用:记录慢查询日志
在my.cnf下开启慢日志记录
slow_query_log = 1
# 默认值为10
long_query_time = 2
# 记录查询过程中未使用到索引的SQL
log_queries_not_using_indexes = 1
binary log
作用:记录数据库更改、表创建、表数据更改信息。也就是记录DML相关的信息。出现那的场景通常为主从复制场景中Master的一方
在my.cnf下开启bin log
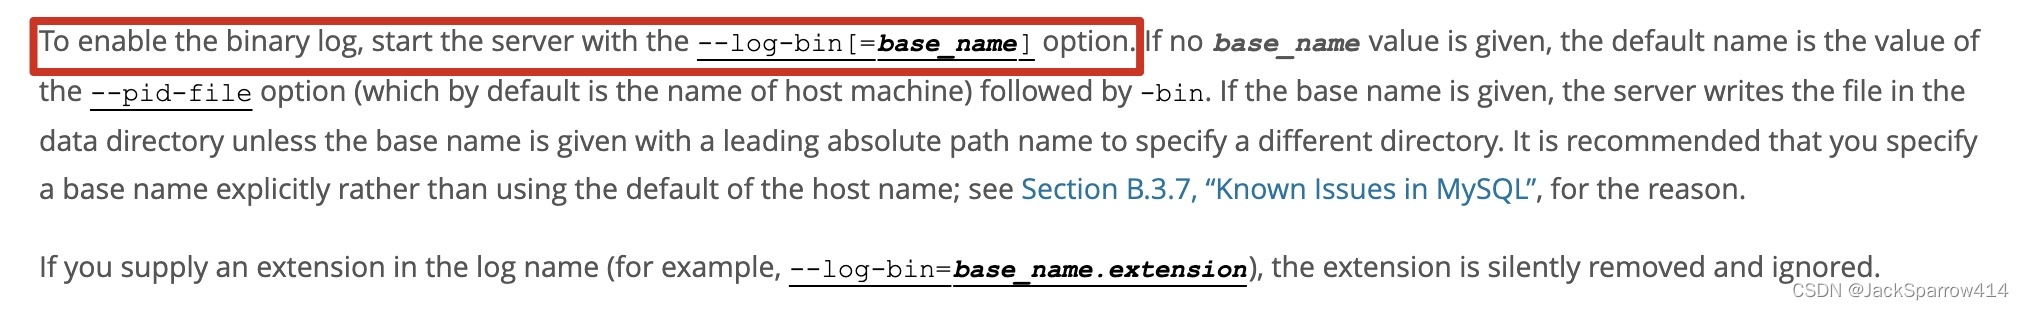
log-bin = mysql-bin
# 每次事务提交,都会同步写到bin log中
sync_binlog = 1
# bin log记录数据格式
binlog-format = ROW/STATEMENT/MIXED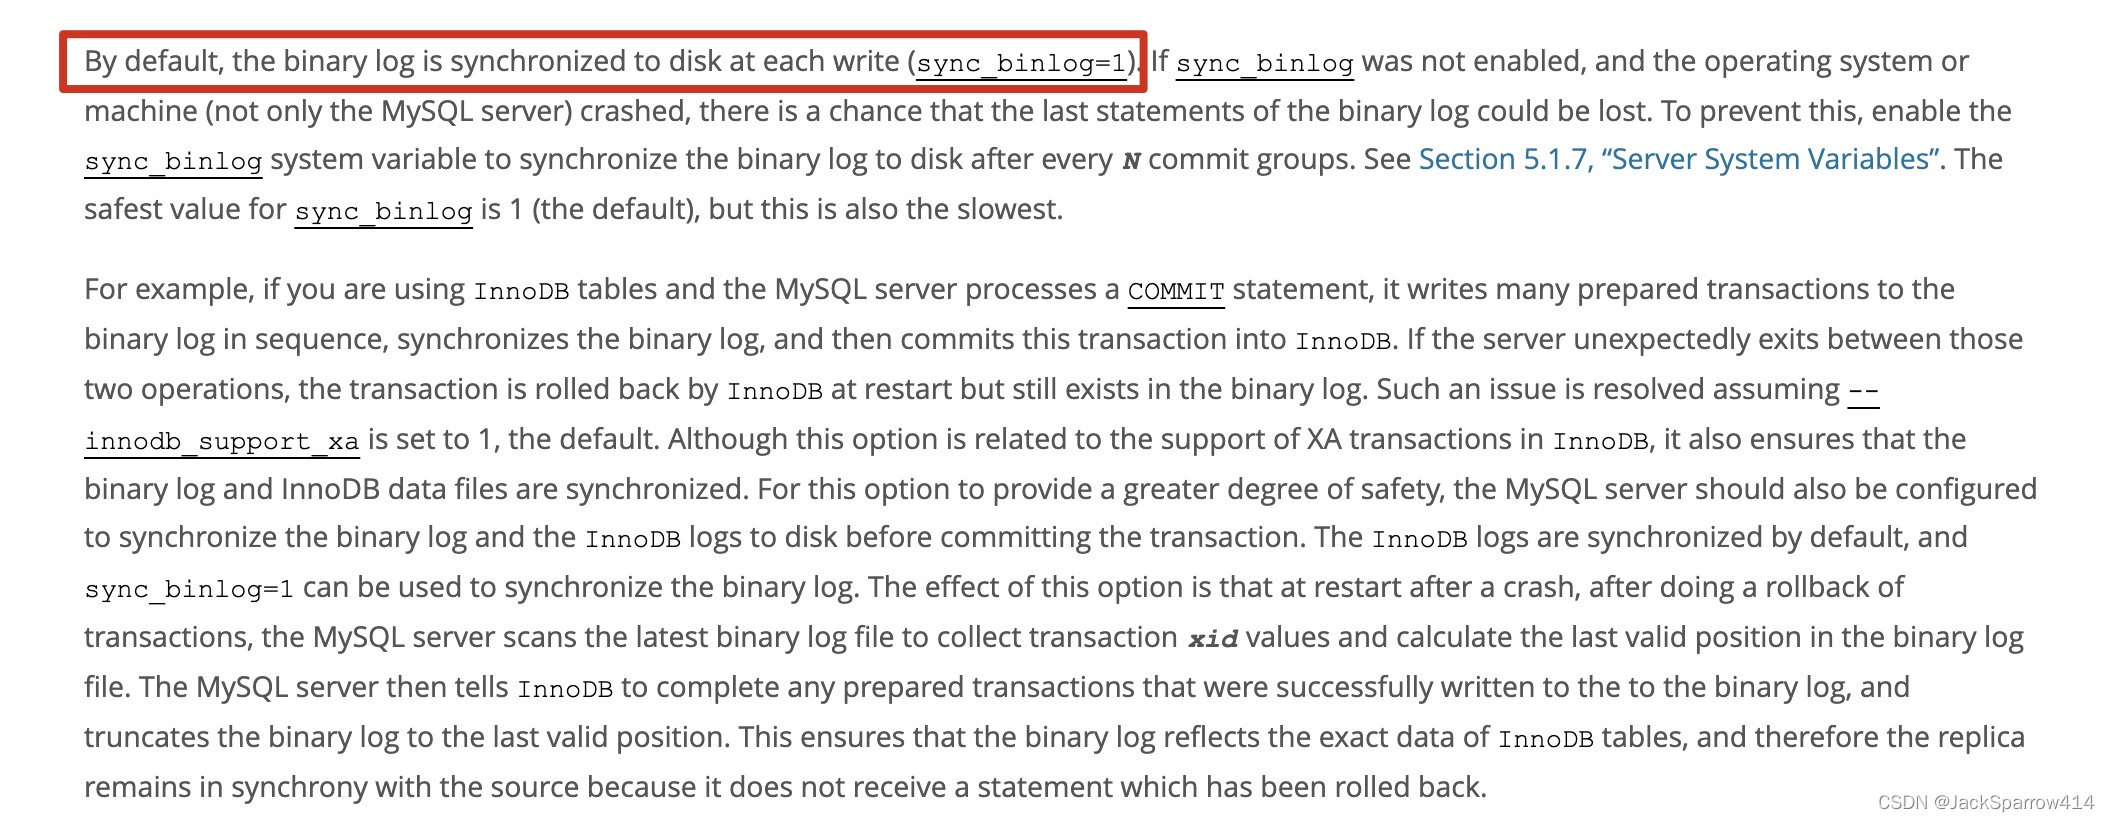
bin log 的记录格式
ROW-每一行真正的数据
STATEMENT - MySQL服务器执行的SQL
MIXED - 上面两种混合
relay log
作用:用来提供给Slave执行的日志,在主从复制场景中,Master发送binlog至Slave,Slave首先会将binlog里的内容写到relay log中,然后Slave线程读取relay log内容,开始写数据到从库中
error log 和 general query log
undo log
记录数据在事务之前的状态,用来实现事务的回滚
- 在修改数据前做undo log记录
- undo log 输入磁盘后,才提交事务
redo log
记录数据事务之后的状态,用来恢复未写入磁盘但是事务已经成功的数据
- 在修改数据后做redo log记录
- log buffer 输入磁盘后,才提交事务
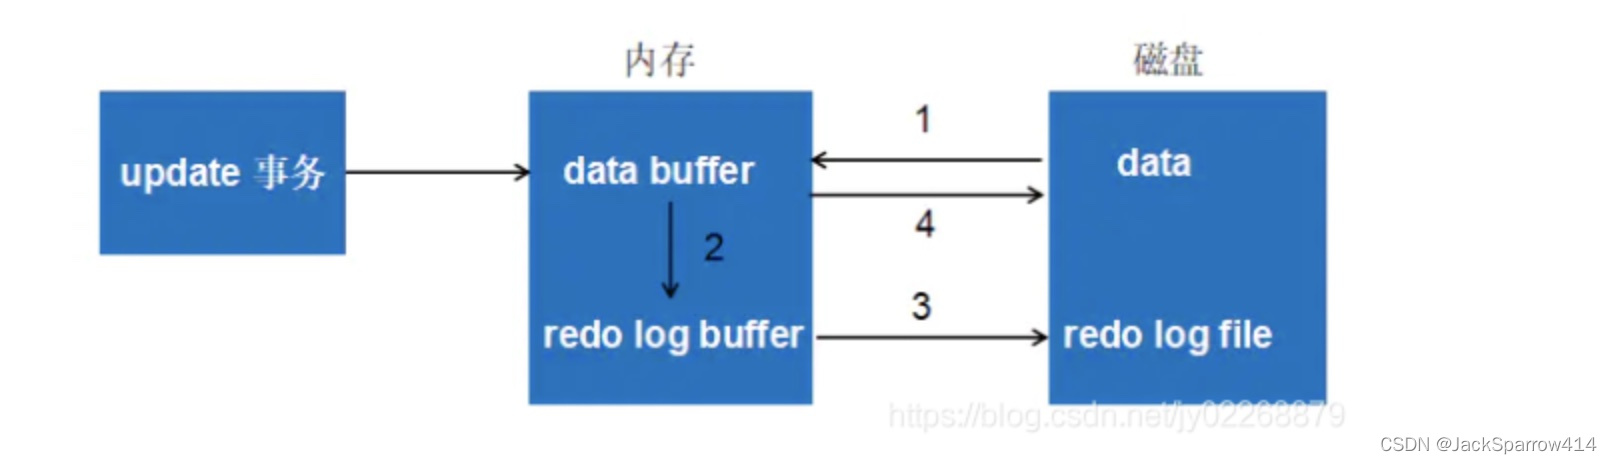
更详细的相关文章可参考这里
好用的资料
- MySQL官方文档
- MySQL官方数据合集查询文档,可以根据相关单词,快速找到相关文档位置,如不清楚DDL、DML、DCL什么意思,来这个地址一查,即可知道