本文导航
展开本文导航
正文
本篇博文分享自己在实践中使用ElasticSearch进行业务开发的一些心得。只讨论应用程序和ElasticSearch交互,至于其他组件,例如Kafak和ElasticSearch的集成则不在本篇博文讨论范围之内。
在业务中使用ElasticSearch中时建议将下列事项作为检查清单,根据实际情况来增减,确保自己在开发过程中思考了下列事项并结合实际情况来完成最终的设计、开发。
该业务为什么需要ElasticSearch? / 该业务需要ElasticSearch的核心功能是哪些?
在使用ES时,我们要问自己的第一个问题是,我为什么拿ES来解决当前业务中的问题?对于该业务的技术问题,团队内的现有技术栈和ES相比有哪些不足?一定要有充足的理由。
正确示例
- 业务需要一个推荐系统,可以利用ES的分词能力来做这件事
- 对于海量数据的模糊查询,已经对数据库索引和代码进行了优化,查询起来还是很慢。所以将数据库的数据同步至ES中,利用ES强大的缓存能力来帮助我们提高模糊查询的性能。
错误示例
- 我看ES好像能干这事,而且网上很多解决方案也是这个。那我们就用。(没有结合当前情况进行思考,直接进行照搬的)
在使用ElasticSearch一些高级功能时,确保该功能是否需要付费的许可证?
该功能是否收费,具体可以在官方订阅说明中找到
如何快速验证分词是否能够满足业务需求?
大部分使用ES场景还是和其分词功能有关。
一个常见的错误开发流程是,上来就开干,直接写代码,周边代码撸完了,结果到最后发现分词有各种各样的问题。所以对于这种关键的问题,我们一开始就要对其验证,只有核心分词没问题且能满足我们的业务需求了,再写代码也不迟。
可以根据业务需求找到合适的内置分词器。找到分词器之后,用一些示例文本在Kibana > Dev Tool中测一下分词效果,见如何测试分词器,例如,我想测一下标准分词器对我们业务的一些文本的分词结果
POST _analyze
{
  "analyzer": "standard",
  "text": "The 2 QUICK Brown-Foxes jumped over the lazy dog's bone."
}
这种方式你能在几个小时之内快速知道哪些分词器能满足当前业务场景并及时反馈给产品团队进行沟通,在需求前期就能快速辨别该需求能不能做,而不是拍着胸脯说,没问题,然后撸了一堆代码,发现业务核心根本没办法实现,自己给自己挖了一个坑。
分词不满足,如何自定义分词?
有很多场景使用内置的分词器可能不满足,例如:使用ES完全达到和数据库like的效果。
自定义分词只需要看官方文档下面几个内容
创建完自定义分词器切记不要忘了上面一条,要先测试过确保没问题,才可进行下一步
业务数据的字段类型映射是否合理?
确定核心分词字段没问题了之后,接下来就要为整个index建立完整的mapping字段。关于字段类型可直接参考官方文档field data types部分,根据实际业务数据类型选择合适的字段类型。同时结合官方文档中的优化索引速度和优化搜索速度中有关index的建议,设计出合理,高效的结构。
实践中如何使用IndexTemplate,Index Alias?
- 建议使用IndexTemplate并按照业务的数据特点对index进行分区。例如,我们需要把每年的订单数据导入到ES中以便快速检索,我们只提供近5年的数据搜索。我们会将index按照年分区,可根据查询区间直接搜索相关的年的index而不是所有index;删除的时候直接将该index删除即可。
- 无论现在用不用Index Alias,我都建议为index设置alias。
业务数据是否可修改?
如果你的业务数据不涉及到更新,写进去就是之后就是查询,类日志数据,强烈建议使用datastream
业务数据需要保留多长时间?/ 如何配置生命周期管理?
index结构创建好了之后,一个关键的问题是该数据需要在ES中保留多长时间,因为机器资源是有限的,不可能不加任何限制的存储数据。
这个问题需要产品团队给出明确的答案。有了明确的期限之后,我们要根据实际情况为index设置生命周期策略。虽然这些活编程式也能干,但是ES既然提供了这个工具,干嘛不用它的呢。有关生命周期的各配置细节解释和具体配置可参考这篇博文
业务数据的增长情况估算?容量估算?
在业务上线之前,需要预估该业务上线后ES中数据容量情况,以便确定当前ES的机器资源是否满足需要,如果不满足应该扩充多少?预估容量也有助于避免由于数据量突增导致ES压力增大,影响到其他使用到ES的业务。
如何正确的计算ES所需要的机器资源呢?我一开始的想法是,计算每条document在ES中的存储大小,然后根据产品给出的预估量,简单计算所需总存储大小是多少。后来发现,社区问过类似的问题,回答是这样没办法做也不建议这样做。因为ES存储会做各种优化、压缩。不可能通过这种方式计算出来,即使算出来也是不准确的。
唯一的可行方法是,预估上线之后数据量有多大,然后按照这个数据量灌到ES里去,观察ES的压力情况,根据实际情况做调整
生产环境集群分级?
以我司现在的现状为例,在生产环境有两套ElasticSearch
- 一个具有3节点的ElasticSearch集群,用来负责重点业务,核心诉求是全文检索+高可用,每个索引配置1副本或2副本
- 一个只有1个节点的ElasticSearch单机,用来负责全平台日志分析,索引采用0副本配置。目前该节点配置是4核16G内存,可以承受60 ~ 70GB的access_log数据。未来接入catalina.out之后可能会拓展为集群
集群分级:将ElasticSearch集群分为高优和低优两类。重点业务使用高优集群,集群的负载控制在低位,索引开启1副本配置,容忍单节点故障;非重点业务使用低优集群,负载控制在高位,索引依然采用0副本配置
上述内容引用自爱奇艺基于数据湖的日志平台架构演进,我们的思路基本和他们一致
一次真实的业务中使用ElasticSearch并优化的过程记录
业务背景
某个功能需要记录用户购买时的行为日志,例如:访问购买页面,通过人机检查,选商品,加商品到购物车,将商品移出购物车,付款。然后分析日志以帮助我们更好的优化销售时的各种配置。
当时决定将这些日志使用异步的方式,提交任务到线程池中,然后通过ElasticSearch Java Client写入到ElasticSearch中。结合业务场景,写入日志的时候可能还会更新一些日志
由于只是接收一些日志,产品环境中的ElasticSearch的配置为2 CPU Core + 16GB 内存 + 几十GB的磁盘空间
大量的写入导致ElasticSearch 响应缓慢从而拖垮应用服务器
在上线1个月之后,忽然有一天,应用服务器大量报警:线程池数量耗尽+响应时间变的很长。 出现该问题的时候,同时注意到了ElasticSearch CPU 升到了80%,并且一直下不来
紧急解决方案
由于当时线上应用服务器都开始出现响应缓慢,已经开始影响一些正常业务了。我们当时立刻打了一个补丁,用来控制是否向ElasticSearch中写日志。上线该补丁后,暂时禁用向ElasticSearch中写日志
问题定位
紧急修复完毕之后,开始调查问题。在查看了相关代码和ElasticSearch该日志的index配置之后,发现有如下几个问题
- 根据发生问题的时间点,发线问题是由一个定时任务触发的。该定时任务使用delete_by_query来定期清理过期的日志
- 对于这种明显的日志类数据,开发人员没有使用data stream 来管理,反而简单粗暴的一股脑的将所有数据写入到一个index里去。到了问题发生时,index大小已经达到了30GB左右。
- 此时使用delete_by_query + ElasticSearch 的配置 直接导致ElasticSearch CPU升高。同时应用服务器还在不断的请求写入日志,更加重了ElasticSearch的负担,形成恶行循环。
- 虽然应用服务器写入的时候采用的是异步的形式,但是其使用的是全局都在使用的公共线程池。大量的写入请求把线程池和其等待队列占满。而我们自定义的公共线程池的拒绝策略是:当队列满+达到最大线程数时,默认阻塞其主线程。这就直接导致了应用服务器一直被阻塞在这里,从而导致应用服务器响应缓慢、性能急剧下降
问题修复
- 要求开发修改其index的配置,使用data stream来自动管理+清理过期日志(如果想要了解data stream的使用,请参考这篇博文)
- 禁止对于大数据集的index使用delete_by_query。如果不能使用data stream,必须根据某一个条件做分区,将不同条件的数据写入不同的index,从而降低某个index的大小
- 为ElasticSearch Java Client集成Circuit Breaker。当响应时间慢时或失败率达到某个程度时,立刻开启Circuit Breaker,使得后续任务快速失败以释放线程。
- Circuit Breaker我们使用的是resilience4j
- 实现方式是在初始化ElasticSearch Java Client时使用Byte Buddy作为动态代理集成resilience4j,来对ElasticSearch Java Client的所有方法进行监控
上线之后,定期清理过期日志由于已经交给了ElasticSearch来处理,没再出现过因为清理日志而导致的CPU升高问题。同时,在ElasticSearch 响应缓慢时,Circuit Breaker会打开不会影响应用服务器的核心功能
短时间+大批量日志写入导致ElasticSearch CPU 升高
修复了第一个问题之后,又观察了一段时间。发现当短时间、大批量的日志写入还是会导致ElasticSearch CPU升高。
问题定位
- 梳理了写日志的核心逻辑,发现其逻辑大致为: 写入一条数据之后,要紧跟一次查询update_by_query
问题修复
-
首先可以优化的地方是,指定index名字,由于上次修复已经把index改为了data stream。但是开发在查询和更新的时候依旧在对整个data stream进行查询,这是完全没必要的。这种日志具有实时性,要更新也是当天的日志,所以让开发在查询时,指定index的名字为data stream的backend index 的前一天+当天+后一天,这3个索引的名字查询即可
-
修改index的refresh_interval为30s
-
在写入数据时,完全可以使用bulk写入。由于是多个线程写入,我们需要让所有线程的写入先暂存到一个地方,然后在这里批量写入。我想起了Kafka就支持批量写入,看了下其源码,找到了解决办法
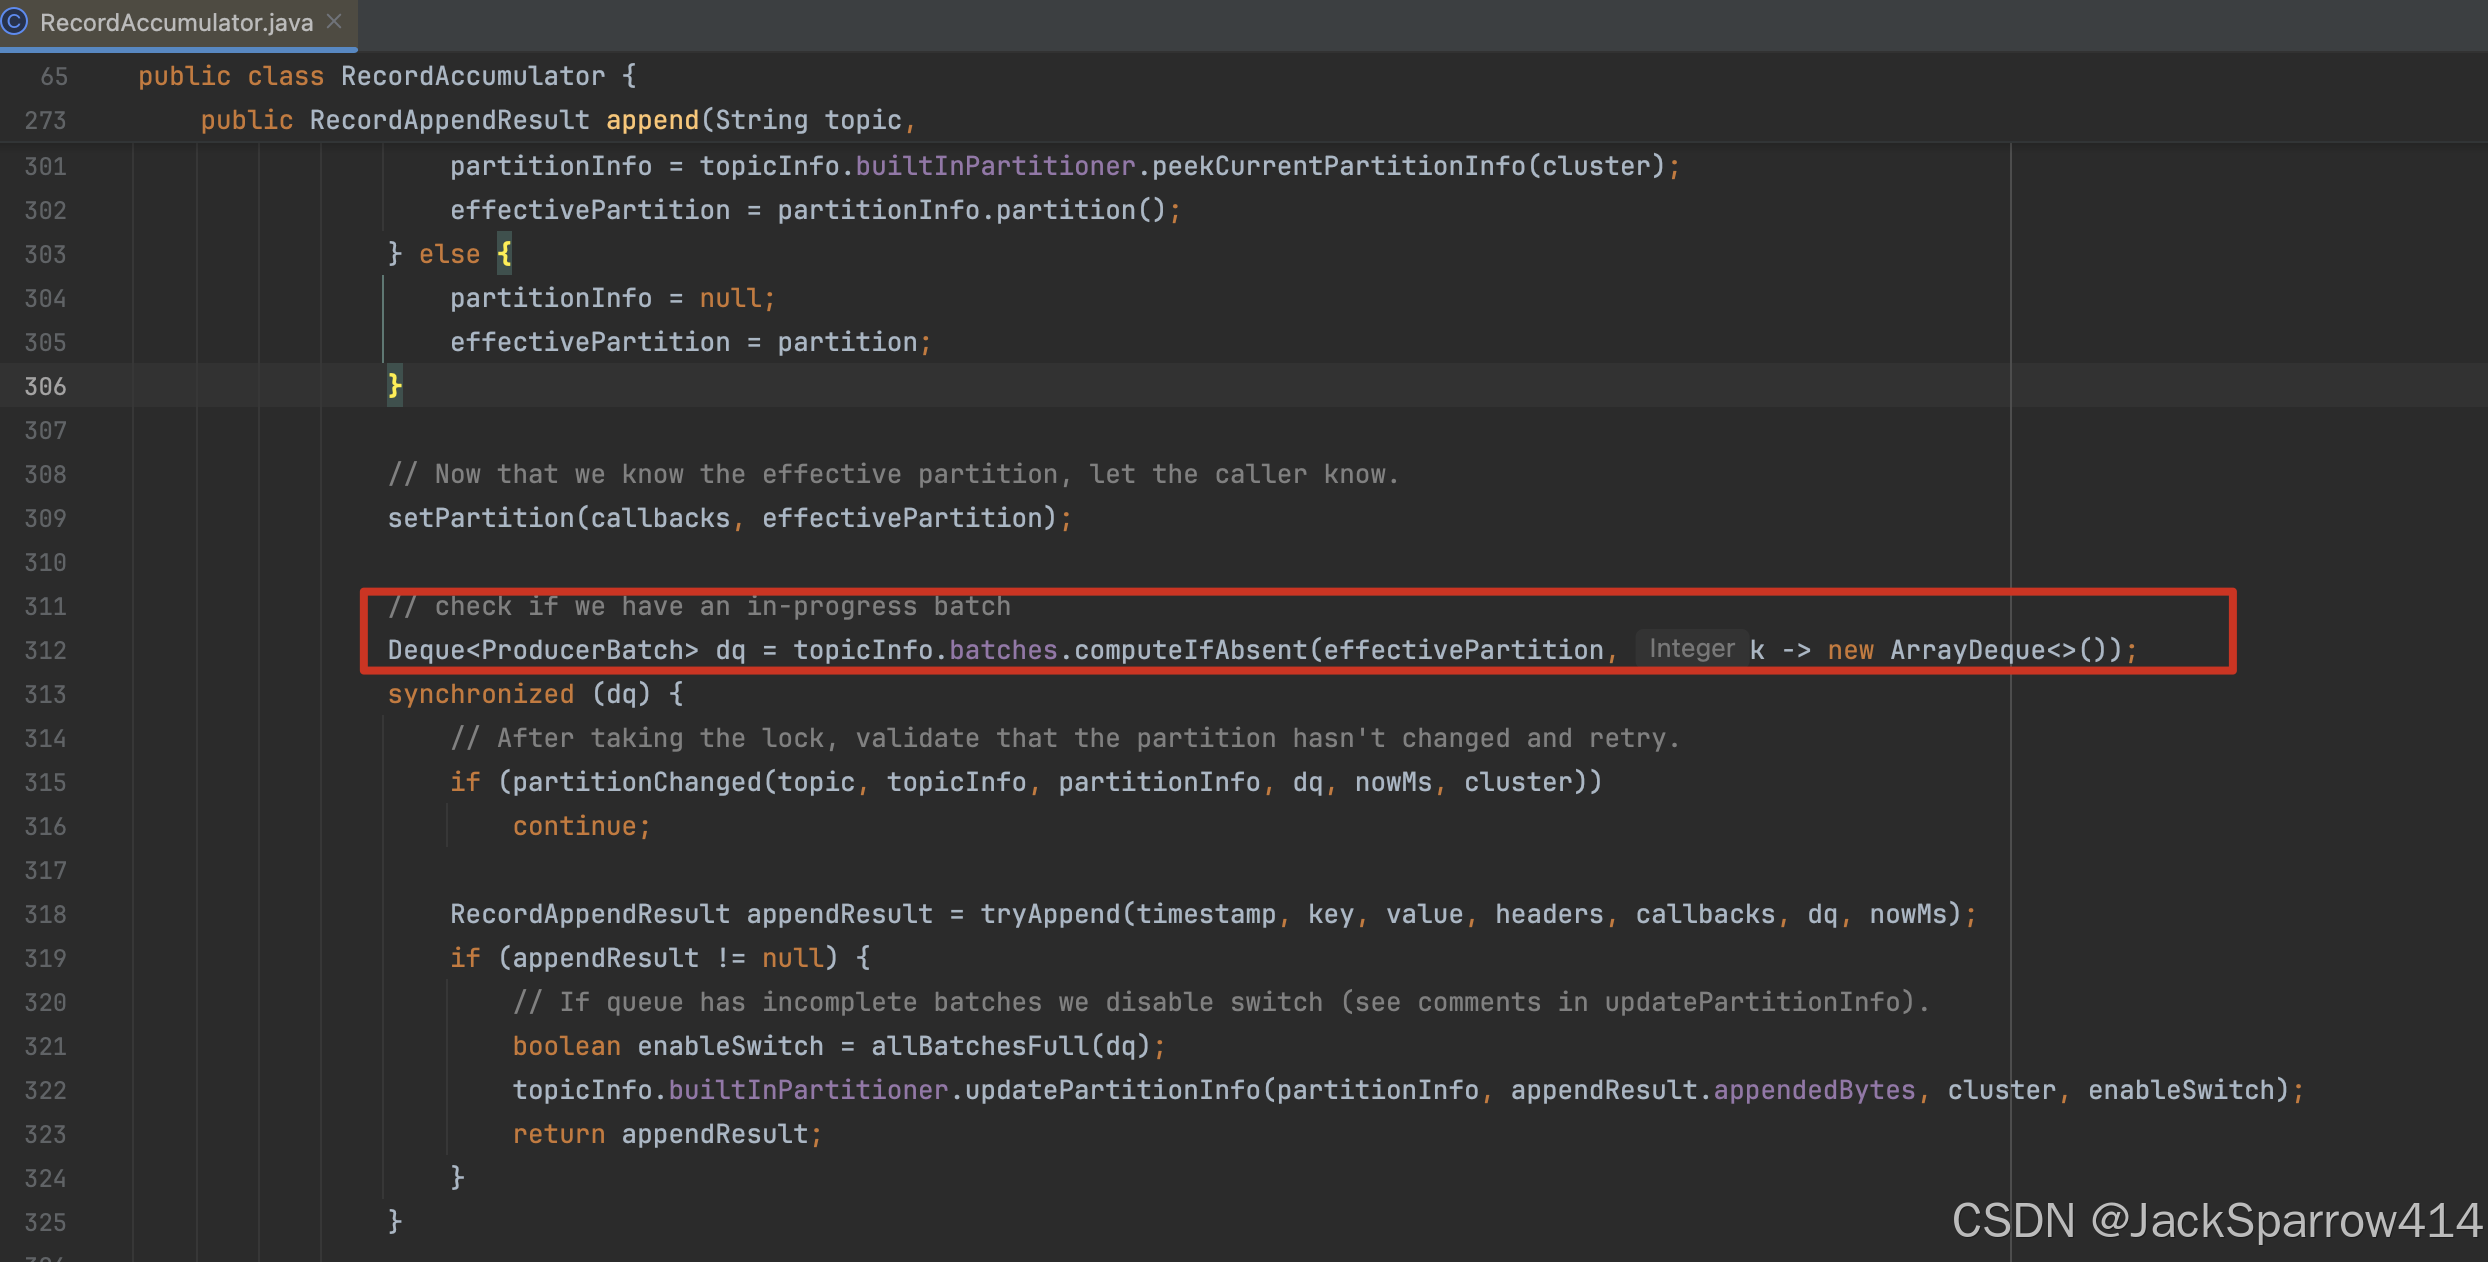
- 使用一个队列即可解决,所有多线程的并发写入,都先写入一个队里里。我们使用的是ConcurrentLinkedQueue以保证多线程并发写入队列是安全的。
- 有1个定时任务,每过30s来消费的队列的日志,使用bulk批量写入ElasticSearch
- 该方法大大提升了写入性能,由于多线程只是将数据放到队列中,所有速度非常快。只实际使用了一个定时任务线程
-
在bulk写入之后,我们又重新优化了update的逻辑,也将其改为批量
上线之后,即使短时间、大批量的生成日志,也不会影响到ElasticSearch的稳定性。CPU使用率从常规40% ~ 60%降低到5%以内
最后
上述所有项都是在业务开发中值得注意的地方。我并没有把每一步的解决方案都详细的写出来,是因为解决方案里链接了大量的官方文档,跟着官方做就可以实现。
真正写代码往往是上述大部分问题都已经确定了之后才开始。
如有更好的开发实践,欢迎留言讨论